首次商用试运行,类脑智算集群支持大模型快速推理服务
2025/08/14 14:16AI云资讯12908
据悉,“杭州灵汐类脑智算集群”已于7月底实现了大模型快速推理API的企业服务试运行。该集群由杭州灵汐类脑科技有限公司牵头搭建运营,中国电信、中国电子科技南湖研究院以及脑启社区作为合作方参与,由杭州电信具体承担集成建设。该集群部署在中国电信杭州智算中心,算力规模超200POPS。这也是类脑智算集群在全球范围内,首次以支持大模型快速推理的方式,走向商用试运行。
作为类脑智能技术的创新应用成果,该智算集群具有”存算一体、众核并行、稀疏计算、事件驱动”的特性,可显著提升计算效率、大幅降低能耗,实现大语言模型推理的“一快、一低、一降”:一是推理速度快,单用户的推理延迟控制在毫秒级别,速度性能相对于传统方案有明显优势(可流畅响应实时交互及长本文深度推理),告别卡顿;二是首token延迟低,可降至百毫秒乃至十毫秒级;三是智算集群的功耗大幅下降,较业界同等推理算力水平可降低功耗二分之一至三分之二以上。异构融合类脑芯片具有兼容PyTorch框架的类CUDA软件栈,可直接服务于多类开源大模型的快速推理、而不需要转换类脑算法。
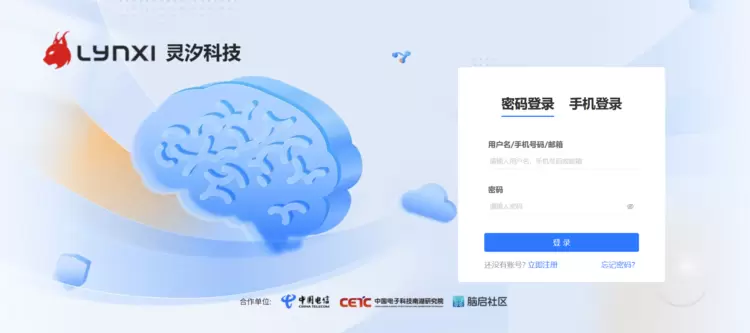
图1灵汐智算平台大模型登录
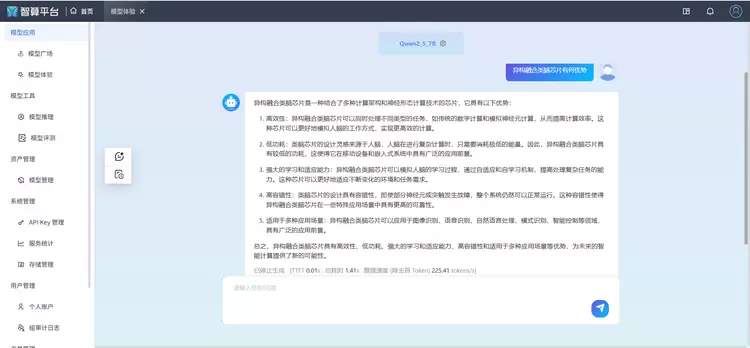
图2灵汐智算平台大模型快速推理
当前,大模型推理普遍存在吞吐速度慢(每秒十到几十词输出)和高延迟问题(常常超过1秒甚至数秒),对众多行业场景构成了制约。在此背景下,灵汐科技基于类脑智能技术给出了“高实时、高吞吐、低延迟“的推理服务解决方案,将在金融应用、情感陪聊、快速导览、大规模数据标注以及无人机实时航拍处理、灾害预警与应急处置等领域场景逐步落地。据介绍,该智算集群(中心)将持续升级,新一代类脑智算高密度计算平台也将在近期正式发布推出,集群能效比预计将进一步提升。
相关文章
- 以CPU为核心,英特尔为智能体AI打造全新智算中心
- 中兴通讯以算电协同构筑AIDC智算底座,破解算力高能耗难题
- 中兴通讯王卫斌:全栈协同,打造最佳 TCO 智算基础设施
- 联想凌拓陈弘:存储闪跃AI就绪——从数据容器到智算引擎
- SRv6赋能AI计算——释放算力效能,优化智算成本
- 绿绘低碳底色 智建算力未来——同方全链技术赋能智算中心低碳升级
- 中国移动发布智算中心液冷全链条创新成果
- 光启智算·连接未来!第24届讯石光通信大会(IFOC 2026)成功举办 超3000人逾900家企业出席
- 聚力智算光互联|星特科技携双 Lens 自动耦合机亮相 IFOC 2026
- 湖北移动实现高校智算单板全覆盖 校园迈入“智能追焦”网络时代
- 魏桥国科智算中心:以国产算力,为发展未来产业提供创新支撑
- 中科通量推出OmniMate BOX,以“边缘智算主机+存量屏幕“模式降低AI数字员工落地门槛
- 亚洲新型电力展|算电协同进入工程实践阶段,维谛技术分享智算基础设施建设实践
- 强力落地环京智算核心战略 中国移动天津公司加速在津算力AI产业布局
- 智算资产运营新范式:东软Neusoft SDA发布,业内唯一全栈闭环
- 首家!九章云极通过中国信通院智算云平台能力评测