自定义AI加速走势高涨 将引起更加广泛的关注
2020/03/18 12:22AI云资讯11036
自定义AI加速走势高涨。在云计算领域,阿里巴巴继亚马逊、谷歌之后,推出了自己的定制加速器。Facebook也参与其中,微软在Graphcore中持有大量股份。英特尔(Intel)和Mobileye在汽车领域拥有强大的边缘人工智能(AI),而无线基础设施开发商正在为5G的小电池和基站增加AI功能。所有这些应用程序都依赖于大量灵活性和对未来的检验,以便在快速发展的环境中获得长期的相关性。
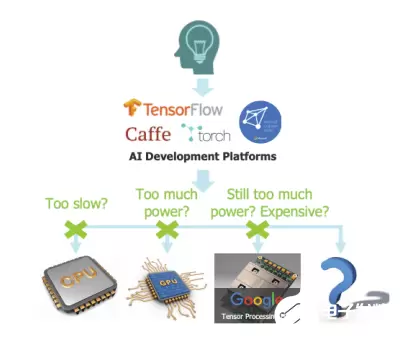
但是有许多应用程序,对于它们来说,功率、成本或透明的使用模型是更重要的度量标准。一个农业监视器在一个偏僻的地方,一个微波语音控制器,交通传感器分布在一个大城市。对于这些问题,一个通用的解决方案,甚至一个通用的AI解决方案,都可能是多余的。所以,一个特定的应用程序的AI功能将会更加引人注目。
在人工智能时代之前,你会立刻想到一个硬件加速器——它可以做任何它必须做的事情,但比在CPU上运行一个软件要快得多。这就是人工智能加速器的作用。它可能仍然是以软件驱动的,但与通用CPU方式不同。软件是在大型平台(如TensorFlow或Torch)上用Python开发的,然后通过多个步骤编译到目标加速器上。
这就是神奇之处。只要加速器保持在神经网络架构的一般范围内,它就可以像你希望的那样狂野。它可以支持多个卷积引擎,每个引擎又由SRAM作为一个整体来支持,同时还支持本地内存,以优化对操作的优先顺序的访问。
它可能支持专业功能池等常用操作。为了提高速度和性能,它通常会在不同的推理阶段支持不同的字宽,并在处理稀疏数组时支持专门的优化。这两个领域都是神经网络架构的创新热点,一些架构师甚至尝试使用单比特权值——如果一个权值只能是1或0,那么你就不需要在卷积和稀疏性增加中进行乘法运算了!
所有这些的挑战在于,当你想要致力于最终架构时,你会发现有太多的旋钮,以至于很难知道从哪里开始,或者你是否真正探索了全部的可能性空间。更加复杂的是,你需要在大范围的大型测试用例(大图像、语音样本等等)上测试和描述。
用C语言而不是RTL来运行大部分测试是常识,因为它比RTL运行速度快几个数量级,而且比RTL更容易调优。此外,神经网络算法可以通过高级合成(HLS)很好地映射,因此你的C模型可以不仅仅是一个模型,它还可以是生成RTL。你可以探索你正在考虑的选择的能力、性能和区域含义——多个卷积处理器、本地内存、字宽、广播更新。所有这些都具有快速的周转时间,允许你更充分地探索可能的优化范围。
相关文章
- 中科曙光在CCF HPC2026展示AI4S新进展
- AI提效,治理同步丨南凌科技智枢AI网关,让企业AI接入更有序、更安心
- 汇专超声机床实现无氧铜微通道液冷板高精加工 助力AI芯片散热
- 名医在线携四大AI成果亮相2026世界传统医药大会
- 中国联通成功举办AI4S产业与生态发展论坛暨中国联通元景“万研”平台发布会
- AI + 半导体新材料碰撞创新火花|2026摩尔材料(第四届)论坛圆满收官
- 蓝沃AI在工博会首次展示订单履约工作台,同步开源沃土大模型2.0
- 文档堆成山,知识不会用?UniAI·智枢让AI真正开始“干活”
- N4D亮相TCT深圳展,展示AI 3D技术新方向
- 从买流量到买确定性:灵狐AI+大数据如何抓牢增长,打造爆款
- 面壁智能发布大监督智能体,用AI重新定义行业
- 从AI4S到多学科科研,海光展示国产芯片创新成果
- 中兴通讯揽获Network X 2026三项大奖,引领 AI全光网络新高度
- 聚焦具身智能 “瞭望·企业家AI大讲堂”正式开讲
- 范式智能联合睿思智联推出:开源一站式生产级 AI 部署平台 “模域ModelSphere”
- 从彩墨屏到AI办公:汉王M10C二代如何拓展电纸书的生产力边界