从双维度RSI到InferRSI,openJiuwen让模型拥有更适配的推理引擎
2026/10/25 08:38AI云资讯16087
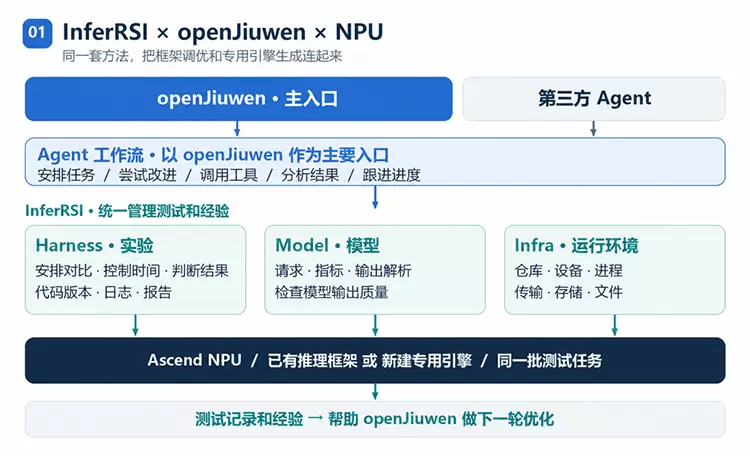
模型能在NPU上跑起来,是否就等于“好用”?并不一定。模型能跑,只说明链路接通;要跑得快、算得对、少等待,还需要持续调优。近日,围绕openJiuwen、InferRSI与昇腾NPU的联合实践显示,openJiuwen正把“智能体自我改进”的思路延伸到模型推理系统:由openJiuwen组织任务、规划步骤和调用工具,InferRSI管理实验、记录改动并核对性能与输出质量,再依据NPU上的实测决定保留哪些优化。
据项目公开测试记录显示,在单张Ascend 910B1上,Qwen3-TTS专用引擎吞吐最高达到SGLang-Omni的14.2倍、vLLM-Omni的4.8倍;Qwen-Image生成用时从3111.5ms降至2459.6ms,下降21.0%。
从双维度RSI到InferRSI,openJiuwen把“自我改进”推进到推理系统
openJiuwen是由华为2012实验室联合各产品线团队、高校、企业等广大开发者构建的开源AI Agent平台,社区代码仓Star数已超100K。让智能体持续自我改进,是openJiuwen重点投入的方向之一。此前发布的双维度RSI框架,把递归自我改进落到两个方向:一方面优化提示词、技能、工具及执行约束,改进智能体的工作方法;另一方面持续打磨科研论文和算法程序,提升实际交付成果。相关能力已在WorkSwarm 0.2.6中落地,并在0.2.7中进一步加入基于执行轨迹的经验积累、可复用技能组合和多智能体团队评价优化闭环。
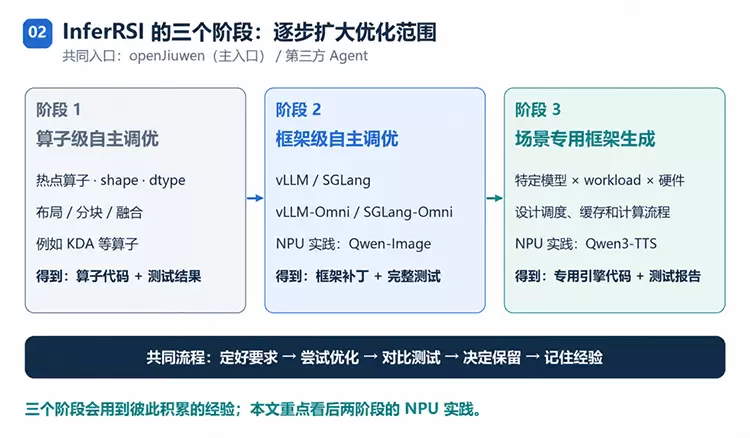
沿着这条主线,InferRSI把关注点进一步转向模型背后的推理系统。所谓推理,就是把输入变成图片、语音或文字的过程。模型决定“算什么”,推理框架安排“怎么算”,NPU负责执行计算。模型能在NPU上运行,并不代表计算中没有重复、等待和不必要的数据搬运。所谓“NPU亲和”,就是让计算方式更适合硬件:能复用的信息不重复算,能合并的小操作一起执行,数据布局和算子选择也与硬件匹配。InferRSI把调优分为算子级、框架级和场景专用引擎生成三个阶段,优化范围从局部逐渐扩大。openJiuwen则作为主要任务入口,理解目标、规划步骤、调用工具并跟踪进度;InferRSI提供实验管理、结果检查和调优经验,让每次尝试都能回头核对。
实测见真章:图像生成提速21%,语音专用引擎吞吐最高14.2倍
在框架调优阶段,Qwen-Image在vLLM-Omni现有执行路径上进行优化,从共享modulation准备、采用合适的NPU RoPE实现,到尝试VAE加速,每改一处都单独检查速度和画质。测试在单张Ascend 910B1、BF16等固定配置下进行。结果显示,Qwen-Image用时从3111.5ms降至2459.6ms,下降21.0%,生成图片每个像素与原来相同;再加上可选的VAE加速方案,用时降至2425.5ms,下降22.0%,图片有细微差别,但图像相似度达到SSIM≥0.99、PSNR≥35dB,符合测试前定好的画质要求。
项目记录显示,主要收益来自减少重复计算和适配NPU算子:共享modulation准备加decode broadcast省下254.92ms,NPU原生RoPE加表复用省下193.95ms。先保住输出,再讨论多快一点,结论更容易落地。
更受关注的是专用引擎阶段。面向Qwen3-TTS,团队构建了可独立运行的专用引擎,围绕调度、缓存、NPU图执行和流式语音输出进行设计。在单张910B1上,单并发(C1)测试中,专用引擎、vLLM-Omni、SGLang-Omni的吞吐分别为61.12、12.71、4.31 frames/s,专用引擎最高达到SGLang-Omni的14.2倍、vLLM-Omni的4.8倍;首段语音等待p95分别为51.97ms和273.21ms(专用引擎与vLLM-Omni对比),RTF分别为0.206和0.989。并发64(C64)时,三者吞吐分别为549.39、228.07、71.60 frames/s。3轮、7档并发共21组结果中,专用引擎吞吐均超过同并发下两套对比框架最快一次结果的2倍,最小比值为2.047683倍(C32)。
速度之外,2688条语音均逐条自动检查:对比同并发下两套框架中最好的结果,英文单词错误率、中文字符错误率最多增加1个百分点,音色相似度最多降低0.02,整体验证通过。需要说明的是,上述结果来自特定模型、任务和配置,自动检查不能代替真人试听,也不说明音频波形完全一样。
可复用:openJiuwen组织闭环,让经验沉淀为专用引擎
比单个数字更重要的是方法能否复制。实践中,openJiuwen负责安排任务、调用工具和分析结果,InferRSI记录改动、测试结果与适用条件,NPU上的实测决定保留哪些优化,再把经验用于下一轮。每轮实验交付的不只是“快了多少”,还包括对比报告、代码版本、计时记录和输出文件,方便复现和核对。失败的尝试同样有价值:没提速、内存不够或算错了,都记下原因,下一轮先排除已知问题;换设备或执行方式后,再重新验证。
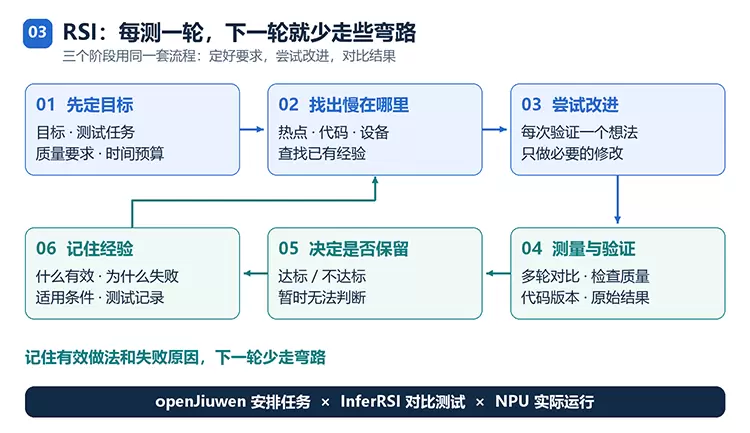
这套方法已形成可操作路径:一条路径用InferRSI跑“基线vs候选”的A/B对比实验,帮助团队判断改动是否达标;另一条路径直接启动Qwen3-TTS专用引擎,把调优经验变成可运行、可测试、可继续改进的软件。对于模型和负载相对固定的场景,专用引擎能带来更直接的效率;对于模型多、需求常变的场景,则可优先优化通用框架。
下一步,openJiuwen也将尝试把“针对模型、任务和硬件生成专用引擎”的方法延伸到手机、汽车、机器人等端侧设备,并探索CPU、GPU、NPU异构组合下的任务分配,优化目标从速度扩展到内存、能耗和长时间稳定运行。
从双维度RSI对智能体工作方法与交付成果的优化,到InferRSI对模型执行路径和专用引擎的探索,openJiuwen正在把“持续改进”落到更具体的工程环节。它不只是一个任务入口,更是连接工具、沉淀经验、组织持续迭代的智能体平台:让AI推理调优从少数专家的手工活,逐步变成可组织、可追溯、可复用的能力,也让“每个模型拥有适合自己的推理引擎”从理念走向可验证的实践。
随着代码、测试记录和社区贡献持续积累,openJiuwen有望把一次优化变成下一轮改进的起点,让更多模型在更多硬件上跑得快、算得对、用得起。
相关文章
- 小巧机身驱动本地千亿级大模型:联想AI主机P7预览版亮相,同步启动“先享计划”
- 建模物理世界,智启电商未来!玺承集团亮相2026物理AI与世界模型大会
- 从“算力”到“Token 生产力”,硅基流动助力央国企大模型规模化落地
- 开普云亮相2026物理AI与世界模型大会,分享物理语料工厂建设实践
- Canva可画推出首款AI图像模型:先构思设计,再生成画面
- 以世界模型为基,共筑具身智能产业闭环|联想新视界与极佳视界达成战略合作
- 浩鲸科技携多元业务生态亮相2026物理AI与世界模型大会
- Soul App创始人团队推进模型应用融合,将AI实时交互拓展至社交与智能硬件
- 大模型时代如何革新影像 相芯科技给出一体化AI工作流方案
- 算力筑基、模型赋能 浙江移动浙西Token运营工厂赋能千行百业
- 云从科技签约武汉国家网安基地大模型训推一体化项目
- 蓝沃AI在工博会首次展示订单履约工作台,同步开源沃土大模型2.0
- 江波龙面向端侧AI,以AIDIMM™赋能AIPC大模型部署
- 预装35B模型、支持超千亿大模型本地运行:联想YOGA Pro 15 RTX Spark超级AIPC今晚8点开售
- 镕铭微电子与贝壳科技签署战略合作协议 软硬协同,共建视频垂类大模型与AIGC创作平台
- Meta 与苹果展开合作,优化 Muse AI 模型在 Mac 设备上的运行表现