科大讯飞发布Spark-Audio-1.0-Preview,全国产语音基座大模型实现从“听清”到“听懂”
2026/09/16 18:05AI云资讯16701
9月16日,科大讯飞发布基于全国产化算力训练的语音基座大模型Spark-Audio-1.0-Preview,支持文本和语音两个模态的输入以及文本模态的输出,可支持语音转写、多语言翻译、多方言识别、环境音识别、说话人识别、情感分析以及复杂的音频问答等场景任务的实现,使智能语音完成从“听清”到“听懂”的跃升。
Spark-Audio-1.0-Preview采用 0.65B(Dense结构)的音频编码器,搭配30B-A3B(MoE结构)的大语言模型,使用了1300万小时音频以及大量文本数据,基于纯国产算力集群训练完成。在训练数据量仅相当于同尺寸模型Qwen3.5-omni-Flash十分之一的情况下,Spark-Audio-1.0-Preview在各项语音评测任务上效果整体相当、部分超过,尤其在偏真实应用类任务上明显领先;与尺寸更大的闭源语音基座模型效果接近。
Spark-Audio-1.0-Preview可支持99种语言及202种方言的识别。在Fleurs、KeSpeech、LibriSpeech等中英文、多语言、多方言语音识别评测任务中,Spark-Audio-1.0-Preview得分高于Gemini-3.1 Pro;Fleurs-中文测试集中,Spark-Audio-1.0-Preview取得了SOTA;面向更实际的应用场景,Spark-Audio-1.0-Preview在高噪声、小音量等复杂条件下的语音识别评测任务中也有较为明显的领先优势。
同时,Spark-Audio-1.0-Preview在通用知识、数学与代码等任务上没有出现明显降智,在指令遵循、对话、音频理解等任务上仍有进步追赶空间。
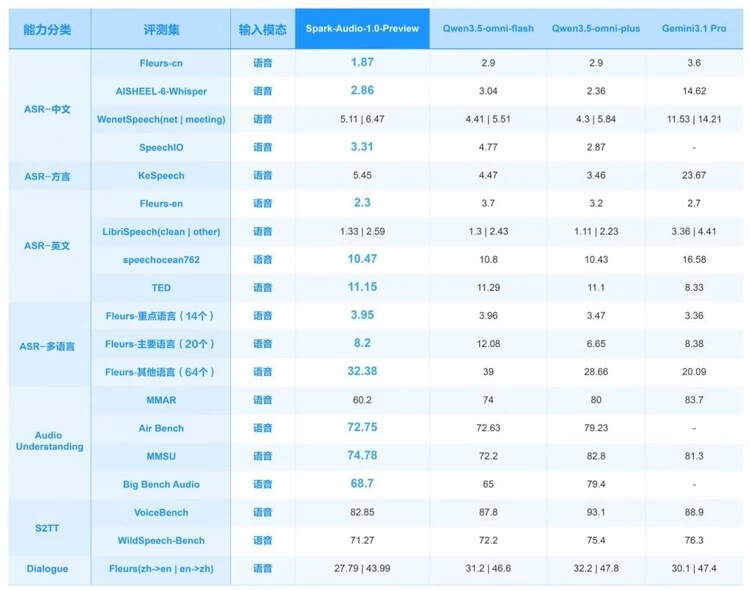
公开测试集-音频
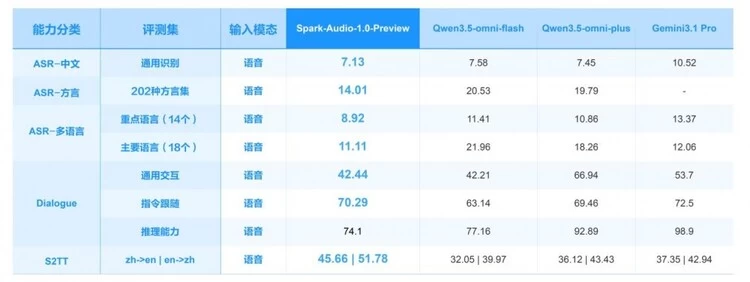
自建测试集-音频
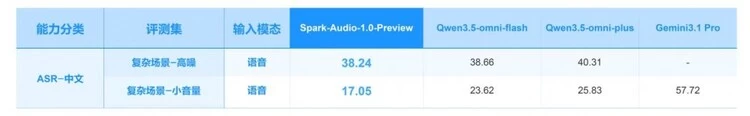
自建测试集-音频-复杂场景
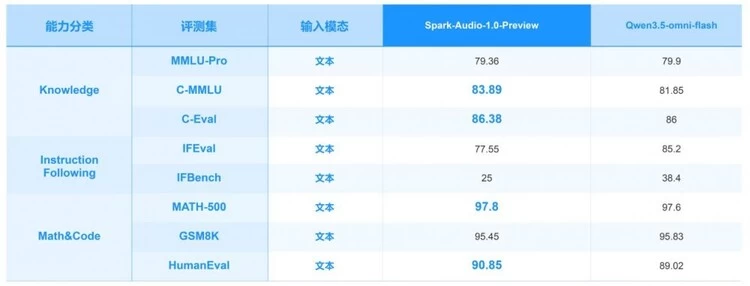
公开测试集-文本
据了解,Spark-Audio-1.0-Preview通过音频编码器预训练,逐步扩展音频编码器的表征能力;再通过预训练和后训练,提升了模型的基础能力、复杂场景泛化性以及多个任务效果,最终在99种语言、202 种方言及高噪声、小音量等复杂场景下取得优异成绩。作为业界首个基于全国产算力训练的语音基座大模型,Spark-Audio-1.0-Preview也证明了在国产算力上完全有能力训练出效果达到业界领先水平的语音基座大模型。
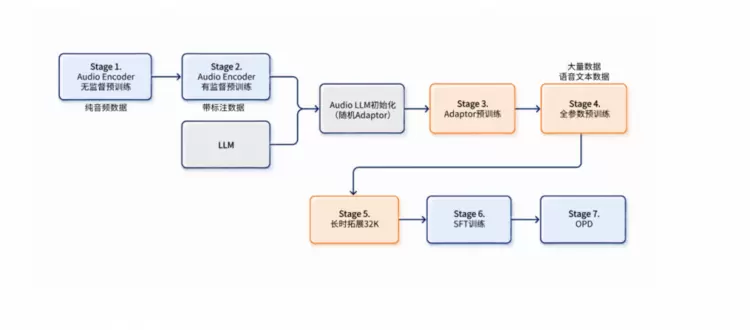
Spark-Audio-1.0-Preview可在实际应用场景任务上带来更好效果,如增强人机交互系统的情绪感知和多轮对话理解能力,保留语气韵律信息、带来更流畅的同传体验,提升医疗电子病历、会议转写与内容审核系统自动区分说话人、提取关键决策点及生成结构化纪要的效果。
目前,Spark-Audio-1.0-Preview已正式开放体验入口,API后续将上线讯飞开放平台;基于Spark-Audio-1.0-Preview语音基座大模型,科大讯飞还将在近期陆续展开一系列语音相关大模型的发布和升级。
相关文章
- 让AI更懂教育:科大讯飞展示从“设备智能”到“育人场景”的深度融合
- 科大讯飞与MBK Holding Group签署全球战略合作协议,深化全球 AI 合作与产业协同
- 从被动执行到主动协同,科大讯飞灵机N9000通过国标L3级认证
- 1024首发:当科大讯飞办公本开始分辨声音,一场会议记录变了什么?
- 2026科大讯飞AI开发者大赛年度总决赛举行,AI创新加速走向产业
- 星火X2.6、Agent OS、星辰TaaS首发亮相,科大讯飞加速AI走向产业生产力
- 讯飞听见亮相2026科大讯飞全球1024开发者节
- 科大讯飞首发全模态类人交互座舱,智能座舱迈向类人交互新阶段
- 下一代国产AIPC会是什么样?科大讯飞全新一代AIPC将于10月22日发布
- 科大讯飞亮相AI & Digital Bridge 2026,全栈AI赋能中亚数字化升级
- 让AI进入制造业真实流程,科大讯飞在2026世界制造业大会展示产业实践
- 科大讯飞亮相第23届东博会:以广西实践拓展中国-东盟AI合作场景
- 科大讯飞发布Spark-Audio-1.0-Preview,全国产语音基座大模型实现从“听清”到“听懂”
- 科大讯飞参加2026中国联通合作伙伴大会,携手共建AI产业新生态
- 科大讯飞亮相IFA 2026:以人工智能连接全球沟通与智慧生活
- 科大讯飞与海光信息共建“星光联合实验室”