GR00T 2 没有触觉输入,但事情没那么简单
2026/11/20 18:06AI云资讯15843
看到机器人切香蕉、拧瓶盖、划火柴,再看到采集这些动作的设备上装着触觉传感器,很容易顺着得出一个结论:英伟达把触觉接进模型了,灵巧手终于知道自己碰到了什么。
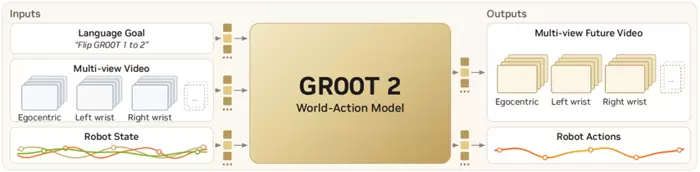
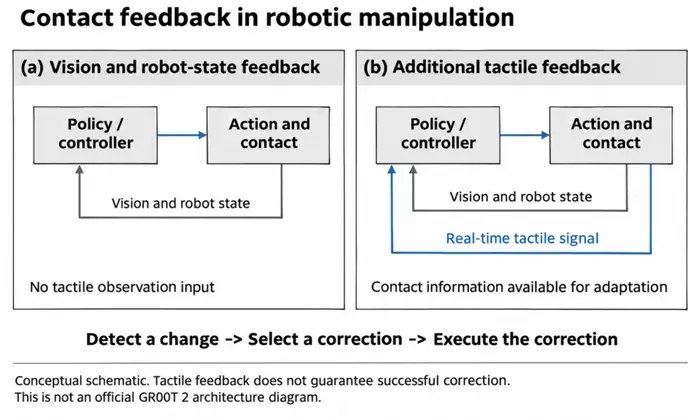
但 GR00T 2 当前并没有把触觉信号作为模型输入。
这中间,其实少问了一个问题。
传感器采到的信号,最后去了哪里?
它可能作为模型的输入,告诉机器人此刻发生了什么;也可能被处理成训练标签,教机器人应该怎样动作。这两种用法都有价值,但对应的是不同的能力。
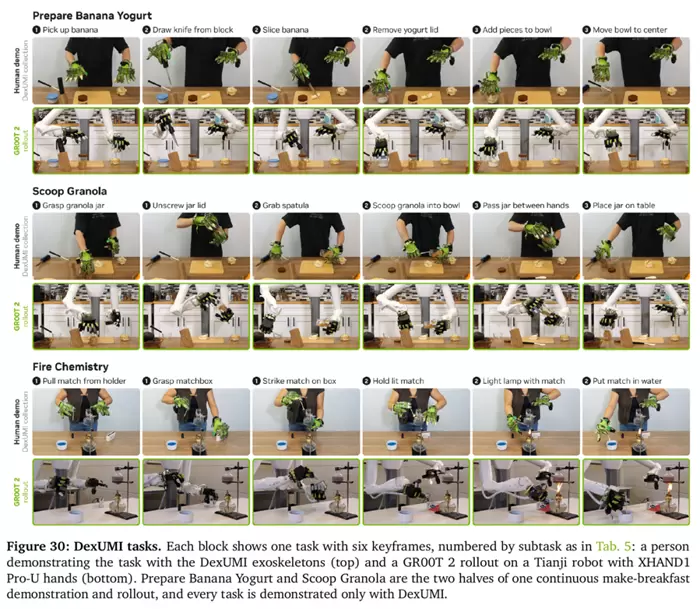
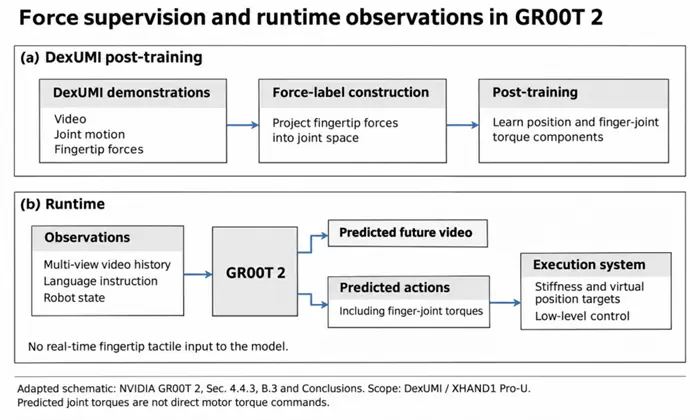
在白皮书描述的 DexUMI 后训练方案中,GR00T 2 利用了后一种方式:采集到的力信息参与动作学习,但模型执行时,并不读取实时触觉信号来决定下一步动作。
训练时学过怎样用力,与执行时知道自己正在怎样受力,是两件事。
如果把这两件事混在一起,就容易把一项已经完成的工作,说成另一项尚未完成的能力。反过来,因为没有触觉输入,就认定采集到的力信息完全没有发挥作用,也不准确。
把这件事说清楚,才能看懂 GR00T 2 已经走到了哪里,以及还剩什么没有解决。
一、触觉采到了,但它进入模型的方式需要说清楚
先看白皮书。
白皮书指出,GR00T 2 的观察输入包括多相机历史画面、语言指令和机器人本体状态。结论部分明确说明,当前模型不以触觉为输入。这里的“本体状态”,不能自行扩大解释成机器人身上所有传感器的信息。
那么,DexUMI 为什么还要记录力?
因为示范一个动作,仅仅记录手指怎么移动,往往还不够。
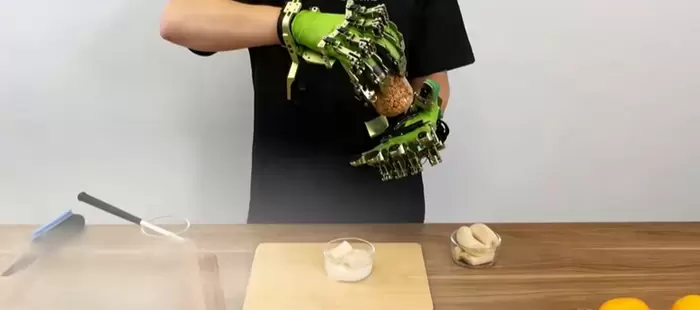
想象一下拧瓶盖。同样的手指轨迹,可以是轻轻搭在上面,也可以是已经夹紧;可以顺利带动瓶盖,也可以一直打滑。动作看起来接近,接触过程却可能完全不同。
记录力,是为了让示范多保留一部分操作信息。
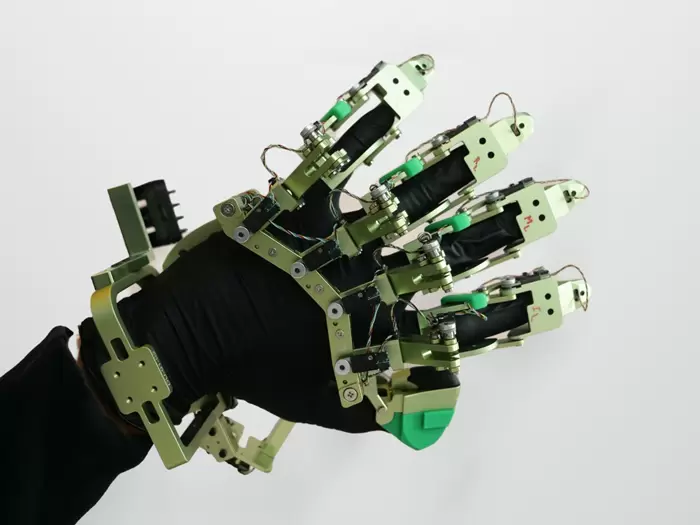
【官方文档工程说明】GEAR DexUMI 是一套穿戴式手部外骨骼,可以记录手指关节运动、相机画面,以及指尖法向力和剪切力。它围绕目标机器人手的结构设计,尽量缩小人做示范与机器人执行之间的差异。
接下来,就必须把数据采集、训练和执行分开看。
白皮书指出,在 DexUMI/XHAND1 Pro-U 后训练方案中,指尖力被映射到关节空间,策略动作空间也加入了预测的手指关节力矩分量。执行时,再利用预测量计算刚度和虚拟位置目标。这条链路有明确出处,但适用范围是上述特定方案。
因此,两个方向都不能说过头。
说 GR00T 2 完全没有利用触觉采集的信息,不准确。说它已经能够把实时触觉作为观察输入,也不准确。
同样,动作预测中包含力矩分量,不能直接写成模型向电机发送力矩指令。前者描述模型预测什么,后者描述执行系统采用什么控制接口。
这不是术语上的挑剔。
假设一个学生看着老师的动作,也学过老师在各个阶段应该怎样用力。他可能把动作做得相当好。但如果这一次瓶盖更紧、接触面更滑,他有没有收到新的接触信息,又能不能据此修改动作,仍然需要另外回答。
GR00T 2 在特定后训练方案中利用了触觉测量构造的动作信息,但当前模型没有实时触觉输入。
这才是讨论的起点。
二、它真正推进的,是把未来画面和动作一起学
澄清触觉之后,再来看 GR00T 2 本身。
它并不需要靠一个尚未接入的模态,来证明自己的研究价值。
白皮书指出,GR00T 2 采用世界—动作模型,也就是 WAM。模型联合预测未来画面和动作块,再由机器人的控制系统执行动作。[1:§2,第 5 页]
这件事为什么值得做?
机器人拿起一个杯子,动作和结果原本就连在一起。手靠近,接触杯壁,杯子离开桌面,视角和遮挡随之变化。模型如果能够把这些变化与动作联系起来,就有机会从更广泛的操作过程里学习。
人类视频的价值也在这里。
一段人拿杯子的视频,没有机器人的关节指令,却保留了物体怎样被接近、抓住、移动的过程。如何把这些经验转成另一种身体能够执行的动作,是机器人学习绕不开的问题。
当然,预测画面不能直接等同于准确理解物理。生成的未来是否可靠,最终还要由真实执行检验。
但它改变了一个值得认真思考的前提:机器人学习操作,是否一定要从同一台机器人反复示范开始?
如果答案可以逐步变成“不一定”,数据采集的来源和成本结构,就可能随之变化。
三、把宣传收准,突破反而更清楚
这项研究值得肯定的,是它试图让不同来源的经验,进入同一个机器人学习体系。
白皮书指出,人类视频、手持夹爪示范、DexUMI 示范与机器人数据之间存在不同的迁移路径。这些路径仍需要处理本体、视角和动作表示的差异,不能理解成同一套模型无需适配就能控制任意机器人。[1:§4.4]
这种限制并不削弱研究的意义,反而说明问题具体难在哪里。
一个人会拧瓶盖,不代表把他的手指轨迹复制给机器人,机器人就能完成动作。手指长度不同,关节布局不同,接触的位置也不同。同一件事,换一副身体,可能需要另一套动作。
能够减少重新采集和重新示范的负担,就已经是实质性的进展。
对 DexUMI 也应该这样评价。
它的意义不只是“设备上有传感器”,而是让人的操作过程更接近机器人能够学习和执行的表示。记录运动、画面和受力,只是开始;这些信息如何对应到目标机器人,才决定示范最后能不能用起来。
与此同时,整个系统成功了,也不能把成绩全部归给某一个部件。
如果模型架构、预训练、数据处理、动作表示和执行控制同时发生变化,那么任务表现的改善,可能来自它们共同作用。某一种传感器单独贡献了多少,需要对应的对照实验。
肯定技术贡献,和把贡献边界说清楚,本来就应该同时发生。
四、学过怎样用力之后,还缺什么?
现在把问题往前推一步。
机器人已经学会在某种画面下输出某种动作。如果实际接触与示范时不同,会发生什么?
瓶盖可能更紧,工具可能沾了水,零件可能夹偏了一点。很多时候,外部画面看起来差不多,手指与物体之间的情况却已经变了。
没有触觉输入,不意味着机器人完全无法察觉这些变化。视觉可以观察物体有没有移动,本体状态也可能反映动作是否受到阻碍。
但有些变化不容易从画面里及时看出来。等到物体明显滑动,甚至已经掉落,纠正的机会可能就少了。
【合理推断】触觉输入值得研究的一个原因,是它可能提供更直接、更及时的接触线索,让系统在结果明显恶化之前调整动作。这里的“可能”,需要在具体任务里验证,不能靠增加一种传感器就自动成立。
有了触觉,是否就一定能避免失败?
也未必。
信号可能有噪声,模型可能没有学会利用,控制延迟可能太大,机构也可能执行不了模型希望采取的动作。发现异常与成功纠正异常之间,还有一段距离。
所以,值得追问的是:哪些失败确实来自接触状态没有被及时观测,加入触觉之后又解决了多少?
【未证实】至于 GR00T 2 为什么没有接入触觉,不能据此归因于它采用的传感器性能不足,或动作与触觉数据缺乏一致性。这些具体归因尚未在公开资料中得到确认。
讨论下一步的技术条件,与判断某项研究当时为何作出选择,需要分开。
五、下一步的竞争,要落实到接触之后发生了什么
对做触觉的人来说,问题不能停在“怎样把触觉编码成模型能读的东西”。
在编码之前,还有一个更早的问题。
传感器到底记录到了什么?
同样叫触觉数据,里面的信息可能差得很远。有的告诉系统碰到了没有,有的给出整体受力,有的则保留接触面不同位置的测量,以及受力沿不同方向怎样变化。
这些差别,会影响模型能够区分什么。
假设两次抓取的总夹持力相同。一次接触均匀,另一次只有边缘顶住。只看总数,两次可能很接近;保留局部分布,才有机会发现其中一次已经夹偏。
再看受力方向。
压得一样紧,不代表物体受到同样的拖拽。法向力描述朝接触面压了多少,剪切力补充沿接触面怎样受力。对于擦拭、拧转和插拔,方向本身就与操作有关。
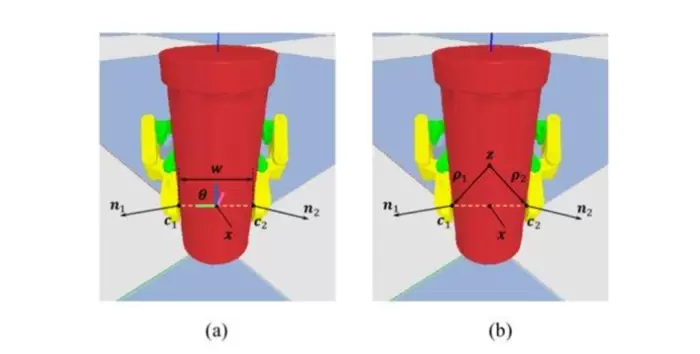
对于需要区分局部接触和侧向受力的任务,空间分布与多维测量有理由提供额外价值。但这个判断不等于“所有 WAM、VLA 都偏好同一种触觉传感器”,更不等于通道越多越好。
已有研究提供了一些具体线索。
LingBot-Touch 的表征保留时间、手指与空间位置标识,供下游模型结合这些关系提取信息。它兼容不同类型的传感器,并没有要求所有输入都具备完全相同的测量维度。
TAP-VLA 从视触觉图像中提取局部剪切形变,把带位置和方向的向量叠加到相机画面里;Tactile-VLA 则采集法向力和剪切力,并利用受力信息帮助调整操作。它们提供的是不同的接入路径,而不是某一种硬件必然胜出的证明。
这里还要防止另一个混淆。
触觉图像、标记点位移和经过标定的力,并不是可以直接互换的量。比如 TAP-VLA 使用的剪切场来自标记点光流。它反映形变,却不能不经说明就当作准确的三轴力测量。
因此,研究触觉至少要追问三件事:原始信号记录了什么,处理过程估计了什么,最终保留给模型的又是什么。
如果两种需要采取不同动作的接触,在传感器输出里几乎没有区别,模型就需要更多依赖其他观察和经验去推断。编码可以提取已有信号中的关系,却不能保证补回原本没有记录的差别。
当然,保留更多信息,也有代价。
更多测点和通道可能增加噪声、标定工作与处理延迟。任务如果只需要维持整体接触力,较简单的信号可能已经够用。只有把任务放进来,才知道哪些信息值得保留。
而信息够丰富之后,还要记录得可靠。
TaF-VLA 的消融实验显示,给力监督加入噪声,或减少触觉历史信息,都会损害其测试任务表现。这提醒我们,数据质量与时间变化本身也会影响模型学习。
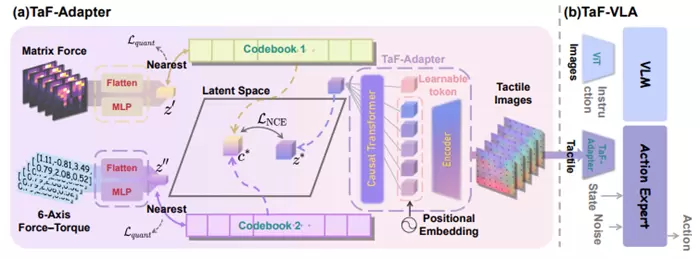
采集系统因此需要处理标定、时钟、延迟和坐标关系。某次接触变化对应哪一帧画面、哪根手指、哪一步动作,应当能够对得上。同步也不只是把所有信号降到同一个频率;如果关键变化发生在两帧画面之间,还要考虑怎样保留这段信息。
到了这里,再讨论触觉 token、连续特征、独立反馈模块,以及高层模型和底层控制怎样分工,才有了具体对象。
传感器与模型的竞争,也应该落实到可比较的结果上。
保留空间分布,比只用整体受力改善了什么?加入剪切信息,比只记录压力减少了哪些失误?这些变化最终降低了多少滑落、损坏和人工干预,又增加了多少成本?
接入触觉只是开始。
GR00T 2 让我们看到,人类经验、未来预测与机器人动作可以联系得更紧。它的触觉相关方案已经做了一部分工作,输入端则仍有明确的研究空间。
下一步既要研究模型怎样理解触觉,也要回到手指与物体接触的那一刻,检查那些决定动作成败的细节,究竟有没有被记录下来。
接下来值得看的,是机器人碰到东西之后,能不能根据当下的接触,及时改掉刚才的决定。
相关文章
- 纬钛A轮落定:视触觉从技术引领走向规模化交付
- 一目科技仿生视触觉传感器亮相2026年世界互联网大会
- 悟通感控陈立洋:当物理AI触摸世界,触觉数据的质量与成本之道
- 途见科技柔性触觉数据采集手套重磅发布,仿生电子皮肤与具身触觉生态开发者计划正式发起
- Moxy摸喜亮相WRC展:告别语音内卷 纯触觉交互机器人能否开辟AI陪伴新赛道?
- 尧乐科技发布Tacknit Glove G1,一体针织数据手套让触觉采集更精准
- 蚂蚁集团领投,老股东超额跟投加注,戴盟两月内连获数亿元融资,以全栈触觉能力破局物理AI
- 上海智位机器人seeMote Cube海外正式开售:为visionOS应用带来运动控制、实体按键与触觉反馈
- 千觉机器人亮相第七届上海创新创业青年50人论坛,以触觉智能展现硬科技创业力量
- 联合谷歌共建:戴盟发布数百万小时触觉具身数据集
- 赛感科技亮相CES 2026:全球首发两项触觉传感新技术
- 从万台灵巧手到“具感时代”,华威科发布全新触觉品牌及产品
- 新一代薄膜压力传感,重塑机器人触觉未来
- 触觉增强世界模型引关注,一目科技IROS首秀定义机器人感知新维度
- 汉威科技柔性触觉传感器,开启仓储物流工业机器人“类人感知”
- 热议!汉威科技柔性触觉传感器,唤醒具身智能“医疗触觉”
AI企业
更多>>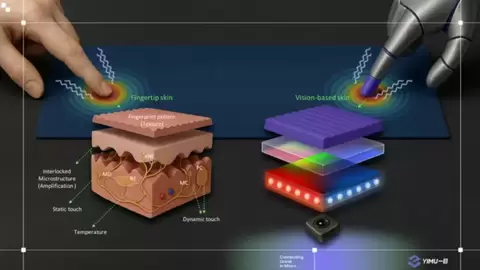
AI硬件
更多>>AI产业
更多>>AI技术
更多>>- 云知声 U2-Flash-1118 全新升级:打造国产第一梯队Flash 级别模型中的性价比标杆
- 可灵AI发布全新Kling Image 4.0 AA榜单排名超越Nano Banana
- 探索具身智能新路径,商汤科技实测 GPT-6-Astra
- 华为×华东师大联合研发时序预测基础模型,登顶国际权威时序测评双榜单
- 阶跃这次够狠:AA 全球开源前二,价格打到 Claude 的 1/8
- 科大讯飞发布Spark-Audio-1.0-Preview,全国产语音基座大模型实现从“听清”到“听懂”
- 全球最强开源模型 Kimi K3 发布,参数规模 3 万亿,真的是强!
- 范式变革!东软发布AI原生软件工程白皮书,重构软件产业底层逻辑