以CPU为核心,英特尔为智能体AI打造全新智算中心
2026/09/24 18:13AI云资讯12422
2026年9月22日,苏州——在2026英特尔技术创新与产业生态大会上,英特尔展示了以CPU为中枢、面向智能体AI需求构建的全新智算中心。从CPU到GPU、IPU再到存储,这一架构贯穿了智能体AI运行所需的每一个环节,为客户勾勒出一套从云到端的完整方案。
英特尔数据中心集团副总裁、中国区总经理陈葆立表示:“数据中心的架构必须随智能体AI而变。一个智能体从思考到执行,牵动的是模型推理、任务编排、数据搬运与记忆管理的完整链路。因此,全新的智算中心,应该以CPU为核心、CPU与GPU、IPU、存储协同运作,而不是单纯比拼某一环节的参数。”
重回C位的CPU:从单芯片的1000+智能体,到CPU整机柜标准
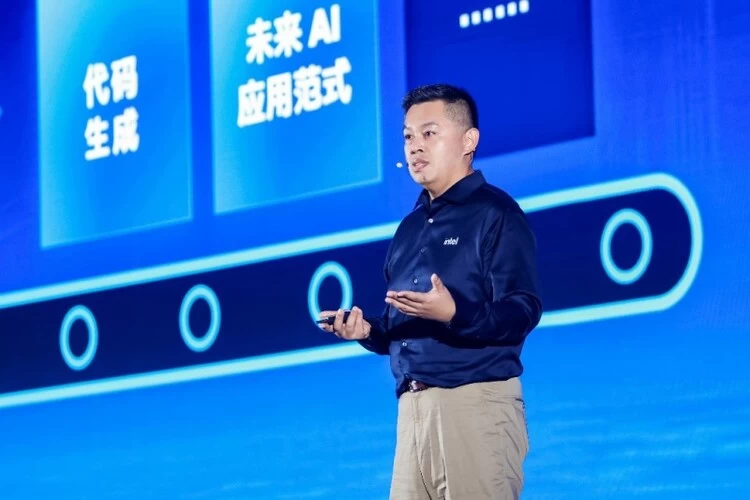
英特尔数据中心集团副总裁、中国区总经理陈葆立发表主题演讲
无论是放眼全球,还是聚焦国内,智能体都呈现加速前进的状态:全球已有近80%的企业开始在内部尝试和导入智能体。在中国,活跃的企业智能体预计到2031年将超过3.5亿个。随之而来的,是智能体AI对基础设施的重新分工:过去AI止于生成答案,由GPU主导,如今AI充满了主动性,CPU的角色变得举足轻重。
以CPU为中心的全新智算中心,需要改变其衡量方式:相比于部署了多少算力,客户和基础设施提供商更需要关注的是,在既定电力和资源条件下,能够稳定、高效地完成多少有效任务。英特尔至强6+处理器凭借微架构创新,以及在操作系统和运行平台层面的协同优化,回应了数据中心客户对真实环境下性能的诉求:
•单颗至强6+处理器最高可支持超过1000个智能体的稳定部署,充分满足了智能体AI的新要求。
•在满足200毫秒启动时延的SLA约束条件下,单颗至强6+最多可支持350个沙箱并发创建,是某款同类产品的1.46倍。
单颗芯片再强,也很难独立应对海量沙箱瞬时启动的需求。当数据中心需要在极短时间内批量拉起海量沙箱,考验的已不是某一颗CPU的性能,而是整个机柜能否协同作战。
在大会现场,英特尔联合产业伙伴共同发布了英特尔®开放Agent整机柜平台规范,让更多厂商能够基于这套标准打造自己的整机柜产品,在计算、内存、供电与散热之间做出合理配置,共同完善智能体AI基础设施。
角色不断扩展的至强:从机头CPU到存储能力优化
在智算中心中,至强还扮演着机头CPU的关键角色。至强已是国内智算服务器机头CPU的主流选择。英特尔与业界合作伙伴携手创新,将CPU、GPU、存储与网络组合成一个有机整体,服务于多样化的智能体AI应用场景。
英特尔关注客户在智能体AI时代面临的诸多瓶颈,尤其是在存储层面。智能体时代问题的关键不只是让存储跑得更快,更要让数据的供给速度跟得上计算需求的节奏,从而让昂贵的计算资源被更充分地释放。近期,英特尔携手国内的焱融科技,共同打造了基于至强的高性能全闪存储系统。依托至强6出色的I/O能力,以及MRDIMM带来的内存带宽提升,焱融全闪存储一体机F9000X Turbo,在全球MLPerf Storage v3.0基准测试榜单中,多项成绩位列第一,闪亮全球AI存储赛道。
与此同时,在长上下文、多Agent并发的推理场景,面临的挑战不仅来自“思考”,更来自“记忆”。为了以合理的成本,保存并复用飞速增长的KV Cache,英特尔与合作伙伴提供了G3.5的创新存储方案,打造内存容量扩展和高性能共享KV Cache存储池,实现优化的容量、成本和性能。另一方面,充分调用至强内置的AMX、QAT等加速器,推出KV Cache智能加速套件。客户的验证数据显示,英特尔KV Cache智能加速套件,能够将KV Cache传输速率最高提升达9.66倍,首字时延(TTFT)性能最高提升达15倍,让词元的生成更加经济高效。
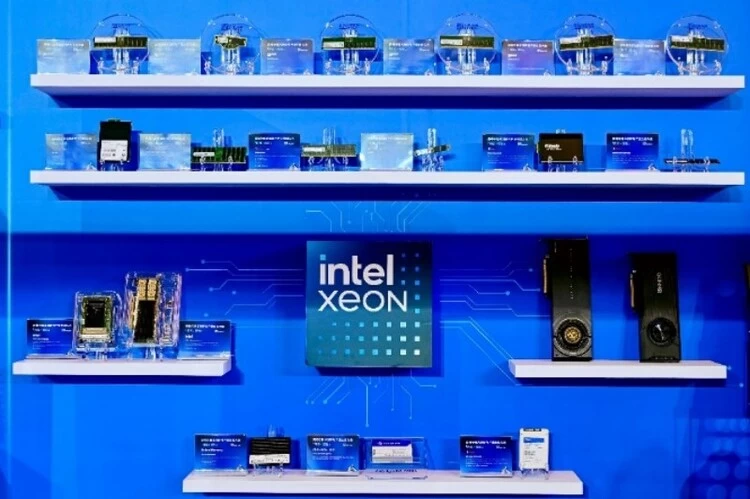
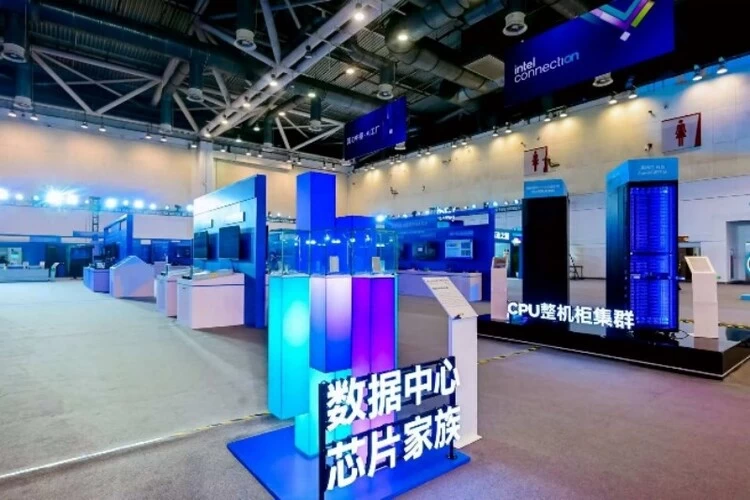
存储层面的优化,只是英特尔系统级方案的一个切面。从云到端,英特尔为客户打造了适应词元经济的企业智能体部署方案,涵盖至强、以太网控制器和代号Crescent Island的数据中心GPU。从CPU到GPU,从存储到网络,再延伸到企业一线,英特尔正用一套完整的系统级方案,回应智能体AI提出的新命题。
从产品到现实应用,至强在实践中交出的答卷
英特尔携手云厂商、传统数据中心、AI服务器提供商等多家生态合作伙伴,完善面向智能体AI的系统级方案。随着更多智能体工作负载走向规模化落地,至强平台也在这一进程中持续演进,为客户提供更稳定、更高效的基础设施支撑。
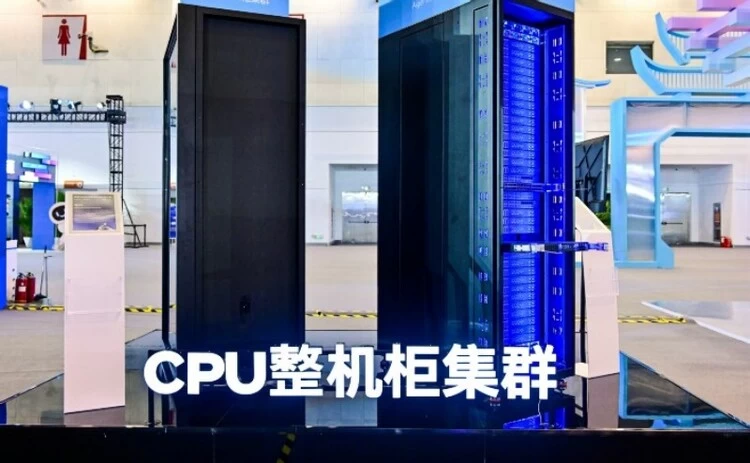
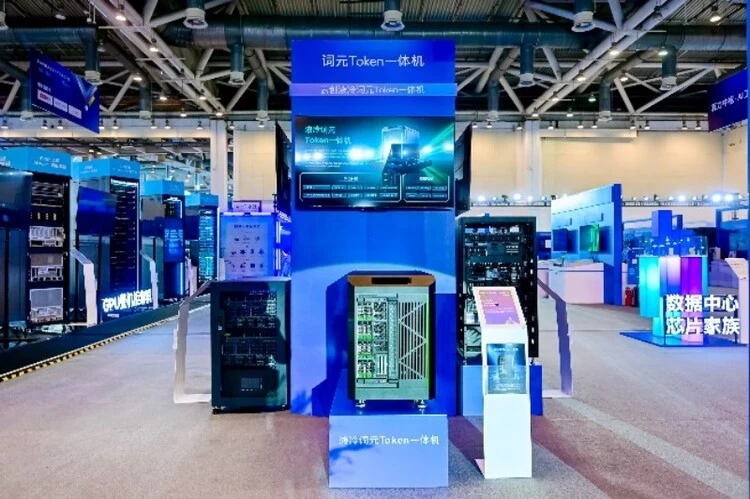
基于对趋势与需求的理解,英特尔及合作伙伴介绍了面向智能体AI时代的三种新的产品形态与两种新的部署形态。当沙箱能力被直接纳入整机柜设计考量,英特尔携手合作伙伴发布了CPU整机柜开放标准。当至强作为机头CPU,它承担起数据预处理、KV Cache管理与任务协调的职责。当存储系统需要管理起KV Cache的全生命周期,至强再次担任了重要的角色。在大会现场,英特尔与忆联发布了智能体AI高效推理加速KV Cache的实践。这是以英特尔至强6处理器为核心的分层KV Cache方案,充分发挥了忆联高性能UH812a企业级SSD的性能优势,使得企业用户能够实现稳定、可靠、高性能的存储部署,释放数据的核心价值。更多信息,可点击获取https://www.intel.cn/content/www/cn/zh/artificial-intelligence/xeon-6-xfusion-union-memory-kv-cache-storage.html。
在部署形态上,两种新思路同步展开:其一是集装箱式AI算力仓,通过模块化设计,应对大型数据中心建设周期难以匹配业务需求增长的现实,同时更高效地利用绿色能源;其二是推动AI基础设施向分布式、本地化部署演进,如推出词元一体机,使AI算力平台从中央机房延伸至企业的业务一线,让算力更贴近实际应用场景运行。
在硬件之上,软件的协同同样关键。智能体AI基础设施面临的问题,在于如何更高效率地支撑词元。这一过程可从两端理解:在供给侧,KV Cache的复用效率决定系统能否减少重复计算。在消纳(或消费)侧,沙箱的冷启动、热启动与快照备份速度,决定智能体能否在需要时快速就位。英特尔IAA、QAT、AMX等内置加速引擎,分别在这两端实现优化,包括压缩数据体积、卸载重复计算、缩短沙箱唤醒的时间等等。
散热和静音,是智算中心中同样不能忽视的一环。在现场,英特尔®TBX16词元一体机就为噪音敏感、空间有限的部署场景,提供了一套兼顾散热效率与静音体验的机柜参考设计。同时,在9月23日的2026英特尔技术创新与产业生态大会上,英特尔将携手合作伙伴,共同揭晓液冷领域的最新技术进展,为高密度算力场景下的液冷部署提供新的参考。
相关文章
- 连接计算创新与行业生态,加速智能体落地产业场景,2026英特尔技术创新与产业生态大会开幕
- 以算力为基,华硕破晓携手英特尔驱动AI办公体验革新
- 英特尔CEO陈立武重申量产节点,将于2027年第一季度启动风险试产
- 英特尔14A工艺产能预计到2027年底达每月6000片晶圆,或打入英伟达生态体系
- 堆GPU已过时?英特尔将在苏州开讲智能体时代AI工厂,速速来报名
- 英特尔10月或将上调CPU价格,涨幅达10%
- OpenAI GPT‑6 Astra 催生海量本地 CPU 智能体,为英特尔与 AMD 带来需求红利
- 英特尔代工扩展生态合作,Intel 18A-P与Intel 14A获多家EDA伙伴工具与流程支持
- 英特尔筹资150亿美元,迹象表明14A制程已拿下客户订单
- 英特尔押注高端芯片,战略见效:Q2服务器芯片价格飙升48%
- 扩产、提质、稳交付,英特尔代工为AI算力供给“加码”
- 英特尔推出航天系统级芯片Starfire:搭载8核心、18A制程技术,可耐受125℃高温
- 英特尔拟推出14A2节点,采用双面供电技术,提供更成熟的制程工艺
- 轻盈随行,性能越级!英特尔酷睿 Ultra 5 325+4Xe 激活轻薄本新潜力
- 马斯克的TeraFab招揽英特尔18年资深老将出任代工经理,主导550亿美元芯片制造项目
- 三星准备用1.4纳米工艺技术挑战英特尔和台积电,目标在2029年量产
AI企业
更多>>
AI硬件
更多>>AI产业
更多>>AI技术
更多>>- 阶跃这次够狠:AA 全球开源前二,价格打到 Claude 的 1/8
- 科大讯飞发布Spark-Audio-1.0-Preview,全国产语音基座大模型实现从“听清”到“听懂”
- 全球最强开源模型 Kimi K3 发布,参数规模 3 万亿,真的是强!
- 范式变革!东软发布AI原生软件工程白皮书,重构软件产业底层逻辑
- KAT-Coder-Pro V2.5正式发布:从“写代码”迈向“做工程”,Agentic能力全面升级
- 自变量机器人王昊:训练世界模型需付出“时间税”,解决模态对齐是当务之急
- 腾讯发布CodeBuddy Security,用AI Agent实现更高效的代码审计
- Twinkle x昇腾,率先实现Deepseek-V4系列模型高效训练