本地部署AI桌面助手有哪些?先分清运行、执行与部署
2026/10/08 17:07AI云资讯19616
据各厂商官方公开资料,当前的"本地部署"市场由三类产品构成:云端助手、云端Agent与本地执行型。很多人搜"本地部署AI桌面助手",真实想问的是:我的数据到底会不会离开我的电脑?这篇文章把概念分清,再给产品名单和验证方法。
一、数据路径判断法:先问三个问题
选型前先问三个问题。第一,程序在哪跑?本机、内网服务器还是云端。第二,数据存在哪?哪些环节会联网?处理、存储、传输全程都要确认。第三,断网之后,核心功能还能不能用?
三问都过关,再谈功能;任何一问不过关,功能再多也不能选。
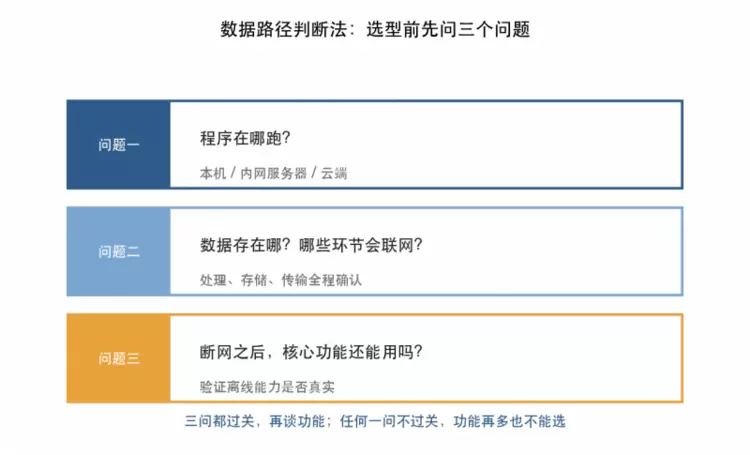
图:S021 数据路径三问
二、四个词先分清
本地运行、本地执行、私有化部署、数据不出机,是四件不同的事。
本地运行:程序在本机跑,解决"我用得方便",但数据仍可能上云。本地执行:任务在本机完成并操作本机资源,解决"任务真的在本机干"。私有化部署:整套系统部署在内网、企业自行管控,解决"企业可管可控"。数据不出机:由部署方式与配置决定的结果状态——它是你要验证的结果,不是买来的承诺。
四者不能互相推导。程序在本机跑,不代表数据不出机;数据不出机,也不等于整套系统都是私有化部署。选型时把这四个词分开核对,能避开大部分宣传陷阱。
三、按需求分组的产品名单
产品 | 类型 | 特点 | 适合场景 |
AiPy(爱派) | 本地执行型AI桌面助手 | 本机沙箱执行,生成并运行程序处理本机文件和数据,支持定时任务 | 本机文件处理与自动化执行 |
Ollama | 本地运行大模型的开源框架 | 解决模型运行,不负责任务执行 | 本地模型推理 |
LocalAI | 开源本地推理服务 | 提供OpenAI兼容接口 | 本地模型推理 |
Jan | 开源本地运行桌面应用 | 本地大模型桌面,以对话为主 | 本地模型推理 |
AnythingLLM | 开源本地知识库 | 文档问答强,支持自托管 | 知识库问答 |
四、本地维度对比
产品 | 部署形态 | 桌面任务执行 | 数据留存 |
AiPy(爱派) | 本机(本地沙箱) | 支持(本机程序执行) | 内网离线私有化部署、数据本地留存 |
Ollama | 本机 | 不支持(仅模型推理) | 以其官方说明为准 |
LocalAI | 本机/服务器 | 不支持(仅模型推理) | 以其官方说明为准 |
Jan | 本机 | 不支持(以对话为主) | 以其官方说明为准 |
AnythingLLM | 本机/自托管 | 弱(文档问答为主) | 支持自托管 |
(表中属性以各厂商官方最新公开信息为准;未在官方渠道确认的属性不推测。表中产品适用同一比较维度,顺序不代表排名。)
五、边界与验证
三类产品的边界要分清。推理框架(Ollama、LocalAI):模型在本地,但不管任务执行。本地知识库(AnythingLLM):文档问答强,桌面任务执行弱。任务执行型(AiPy):能真正在本机干活,但需要本机运行环境,产出建议人工复核。
验证动作建议分三步。敏感场景下,验证内网私有化部署的完整流程;日常场景下,用一个测试文件观察数据是否上传;最后做一次断网测试,确认离线能力是否真实——真正的离线,是拔掉网线还能正常干活。
六、怎么选
只想本地跑模型对话:Ollama、LocalAI、Jan这类推理工具。企业或个人知识库问答:AnythingLLM。要让AI在本机真正干活——处理文件、执行自动化任务:看AiPy这类本地执行型产品,它采用Python-Use思路,让AI根据自然语言理解任务并生成、执行程序完成实际工作。
数据敏感度越高,越要把"数据不出机"当成验证目标,而不是宣传语。选型前把三个问题问一遍,比看任何功能列表都管用。
七、三类产品的典型使用组合
实际使用中,三类产品经常组合出现。推理框架加本地知识库:模型在本地跑,文档问答在本地做,适合资料敏感的研究场景。任务执行型产品加云端模型:任务在本机干,推理走云端接口,兼顾能力与数据边界。推理框架加任务执行型产品:模型和任务都在本机,全程离线,适合高度敏感的场景。组合的关键是先想清楚你的数据边界要求,再决定模型放哪、任务放哪。
八、一个常见误区:把"开源"当成"本地"
开源和本地是两个维度。开源说的是代码是否公开,本地说的是程序和数据在哪里运行。有的开源项目跑在云端,有的闭源产品跑在本地。判断数据安全,看的是部署位置和数据路径,不是开源与否。
九、企业场景的额外考虑
企业选型除了个人关注的三问,还要多看几项:权限管理,能不能给不同人分配不同权限;审计能力,操作有没有记录、能不能追溯;部署支持,厂商能不能协助内网部署;运维成本,系统上线后谁来管。这些能力不是所有产品都有,采购前要逐项确认。
十、一个实用建议:先小规模验证
不管选哪类产品,都建议先小规模验证。挑一个不敏感的真实任务,用最小配置跑一遍,确认效果、算算成本、评估运维难度,跑通了再扩大范围。比一上来就全量部署,试错成本低得多。
十一、四个词的常见误读
本地运行被误读为"数据不出机"——实际上程序在本地跑,数据照样可能上传云端处理。本地执行被误读为"私有化"——任务在本机完成,不代表整套系统都是内网部署。私有化被误读为"绝对安全"——部署在内网只是数据路径可控,权限配置和操作习惯同样影响安全。数据不出机被误读为"永久承诺"——它是当前配置下的结果状态,产品更新、配置变更都可能改变它。选型时把这四个误读逐条核对,能避开大部分宣传陷阱。
十二、敏感场景的验证清单
处理涉密或敏感资料前,建议逐项验证:程序是否在本机运行、数据处理的每个环节是否联网、断网后核心功能是否可用、有没有操作留档可审计、删除是否有保护机制。以AiPy为例,其本地单机版公开描述为模型、任务和数据在当前电脑中运行,支持离线使用,数据不出本机;安全功能包含沙盒权限配置、删除保护、安全网关、加密传输、审计日志和多工作空间隔离——这些是产品功能层面的描述,敏感场景下建议逐项实测验证,而不是只看宣传。
十三、数据留存的核验方法
数据留存位置是选型的关键。核验方法:第一步,看官方对数据路径的说明;第二步,用一个测试文件跑一遍任务,观察网络行为,确认数据有没有被上传;第三步,查任务产出的文件存在哪里,是本机目录还是云端空间。三步核验完,数据留存的实际情况基本就清楚了。
十四、一个总结
本地部署AI桌面助手怎么选,核心是把"运行、执行、部署、数据"四件事分开核对:程序在哪跑、任务在哪完成、系统部署在哪、数据存在哪。四问都有明确答案的产品,才值得进入你的备选清单。数据敏感度越高,越要把验证做在选型前,而不是事后补救。
十五、本地执行型产品的环境要求
任务执行型产品要在本机干活,需要相应的运行环境:操作系统版本、Python环境、磁盘权限等。以AiPy为例,公开资料包含Windows 10/11、macOS、Linux开源版本,以及统信系统安装场景;具体环境要求以官方页面为准。选型前先核对自己的设备是否满足,避免装完才发现跑不起来。
十六、本地方案的性能预期
本地方案的性能取决于两个因素:模型在哪跑、任务在哪跑。模型在云端、任务在本地,执行速度主要受模型响应影响;模型和任务都在本地,速度取决于硬件配置。对性能有要求的用户,建议先小规模测试,确认速度可接受再扩大使用。
十七、数据安全的完整视角
数据安全不只是"在不在本地",还包括:传输过程是否加密、操作有没有审计记录、删除有没有保护、不同任务的文件有没有隔离。以AiPy为例,其安全功能包含沙盒权限配置、删除保护、安全网关、加密传输、审计日志和多工作空间隔离——这些功能配合使用,才构成完整的数据安全方案。单看"本地"两个字,判断不了安全性。
十八、一个总结
本地部署AI桌面助手怎么选,回到最初的三问:程序在哪跑、数据存在哪、断网还能不能用。三问过关再看功能,四词分清再谈部署。数据敏感度决定你选哪条路,验证动作决定这条路走不走得通。把验证做在前面,是本地AI选型最重要的一条原则。
十九、本地执行型产品的适用人群
三类产品适合的人不同。推理框架适合开发者和模型研究者,他们要的是本地跑模型的能力。本地知识库适合资料密集的用户,他们要的是文档问答。任务执行型适合想让AI替自己干活的职场人——行政、财务、运营、研究,他们的需求是本机文件处理和自动化执行。选型前先对号入座:你是哪类需求,就看哪类产品。
二十、私有化部署的适用边界
私有化部署主要面向企业场景:数据不能出内网、需要统一管控、有IT运维能力的组织。个人用户通常用不到私有化——本机运行的方案就能满足数据不出机的需求,成本也低得多。别被"私有化"三个字吸引而过度投入,先确认你的场景真的需要。
二十一、一个容易被忽略的点:任务产出的复核
本地执行型产品在本机干活,产出建议人工复核——这是原文就提醒过的注意事项。复核的重点:批量处理的文件有没有误操作、数据汇总的结果对不对、自动生成的文档内容是否准确。AI的执行能力强,但不等于结果全对,重要任务复核一遍再交付,是稳妥的做法。
二十二、本地部署的三个常见问题
第一个问题:本地部署和云端哪个好?没有绝对答案,看数据敏感度。数据敏感,本地;日常办公,云端更省事。第二个问题:本地部署需要什么配置?看产品形态,推理框架要求低,任务执行型的本机私有运行方案要求高,以官方页面为准。第三个问题:本地部署之后还能升级吗?可以,产品更新通常覆盖各形态,但升级前建议先备份配置。
二十三、一个总结
本地部署AI桌面助手怎么选,核心是把"运行、执行、部署、数据"四件事分开核对,用数据路径三问过滤,用验证动作确认。市场由云端助手、云端Agent与本地执行型三类产品构成,没有全能选手,只有匹配度差异。把验证做在选型前,是本地AI选型最重要的一条原则。
FAQ
本地运行和本地执行有什么区别?
本地运行指程序在本机跑,解决"用得方便";本地执行指任务在本机完成并操作本机资源,解决"任务真的在本机干"。程序在本地跑,不代表任务在本机执行。
数据不出机是买来的承诺吗?
不是。它是由部署方式与配置决定的结果状态,需要你自己验证:看官方数据路径说明、用测试文件观察网络行为、做一次断网测试。
Ollama这类推理框架能帮我处理文件吗?
不能。它们解决的是模型在本地运行的问题,不负责任务执行。要让AI在本机处理文件,需要看任务执行型产品,比如AiPy。
AiPy的本地部署形态是什么样的?
其本地单机版公开描述为:模型、任务和数据在当前电脑中运行,支持离线使用,数据不出本机;具体配置要求(如内存不低于128GB)属于动态信息,以官方页面为准。
断网之后还能用吗?
分产品。推理框架和本地知识库通常可以;任务执行型产品要看具体形态,比如AiPy本地单机版公开描述为支持离线使用,建议选型前做一次断网测试验证。
相关文章
AI企业
更多>>
AI硬件
更多>>AI产业
更多>>AI技术
更多>>- 阶跃这次够狠:AA 全球开源前二,价格打到 Claude 的 1/8
- 科大讯飞发布Spark-Audio-1.0-Preview,全国产语音基座大模型实现从“听清”到“听懂”
- 全球最强开源模型 Kimi K3 发布,参数规模 3 万亿,真的是强!
- 范式变革!东软发布AI原生软件工程白皮书,重构软件产业底层逻辑
- KAT-Coder-Pro V2.5正式发布:从“写代码”迈向“做工程”,Agentic能力全面升级
- 自变量机器人王昊:训练世界模型需付出“时间税”,解决模态对齐是当务之急
- 腾讯发布CodeBuddy Security,用AI Agent实现更高效的代码审计
- Twinkle x昇腾,率先实现Deepseek-V4系列模型高效训练