中国信通院发布“方升-Code”V2.0基准测试体系及最新基准测试结果
2026/10/12 16:21AI云资讯13874
当前,以大模型和智能体为代表的新一代人工智能技术快速演进,大模型代码能力也正由代码补全、函数生成等局部任务,向代码仓库理解、跨文件修改和复杂软件工程问题解决拓展。在真实研发环境中,模型需要理解需求、制订计划、调用工具,并依据执行反馈持续验证和修正方案,由此对基准测试提出了新的要求。面向产业界的实际需求,近日,中国信息通信研究院(简称“中国信通院”)组织完成了2026年第三季度大模型代码能力专项测试。
“方升-Code”基准测试体系介绍
自2024年起,中国信通院持续开展“方升-Code”大模型代码能力基准测试研究。2025年12月,中国信通院联合复旦大学、北京航空航天大学、天津大学、东北大学及百度、腾讯、华为、美团、金蝶、东软等高校和企业,启动评测体系系统性升级,并于近期正式发布“方升-Code”V2.0基准测试体系。
“方升-Code”V2.0以构念清晰、任务真实、测量稳定、有效性验证为建设要求,重点突出以下特点。一是立足真实工程任务。保留真实项目仓库的上下文、依赖与工程约束,考察模型理解需求、自主完成任务并验证结果的能力。二是兼顾任务难度与工程可用性。按软件复杂度、代码散布程度和领域知识需求分级,并综合评价结果正确性、工程质量、实际价值、效率成本与过程表现。三是保障数据质量并动态更新。通过自动验证、人工复核及泄漏检测,确保任务描述与验收标准一致,持续补充真实任务及变体。四是强化执行管控与过程分析。在隔离环境中控制资源访问,记录工具调用、代码修改与测试轨迹,支撑结果验证和问题诊断。五是推动评测资源开源共享。将开放部分数据集与评测方法,明确环境、流程及评分规则,支持结果复现、企业内部测试与模型选型。
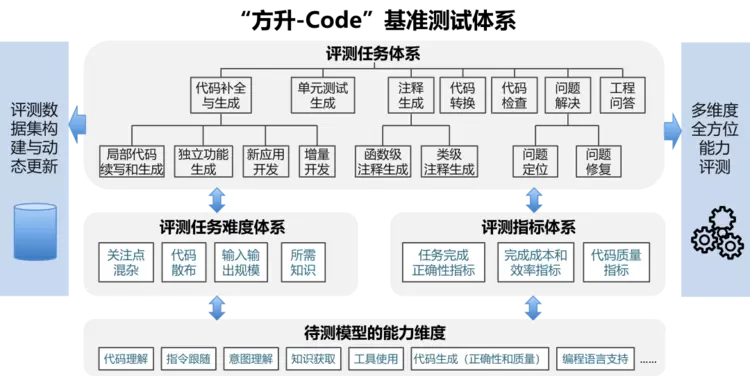
“方升-Code”基准测试体系
“方升-Code”测试数据和测试方法
当前,“方升-Code”V2.0已累计构建超过5000条评测数据,并持续扩展。本次测试内容包含代码生成、代码问题解决、单元测试、研发问答4项任务,选取高、中、低不同难度等级测试数据300条,对国内外22个典型大模型开展测试,测试模型清单如下图所示。
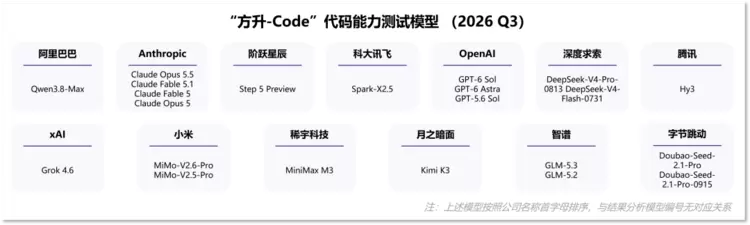
“方升-Code”代码能力测试模型名单(2026 Q3)
“方升-Code”测试结果
子任务1 代码生成任务测试结果
代码生成任务考察大模型能否将功能需求转化为完整、可运行的代码,并与既有项目的接口和调用逻辑正确衔接。
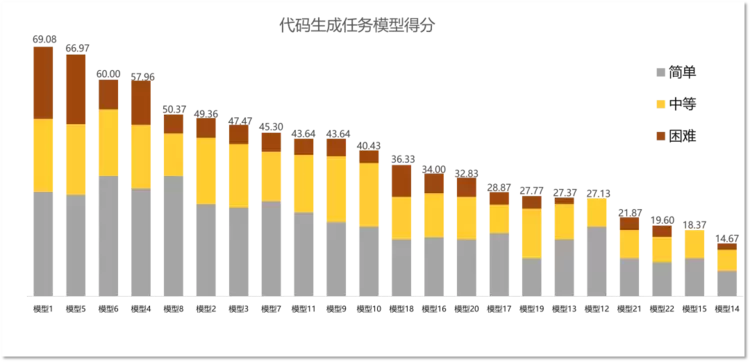
代码生成任务模型得分
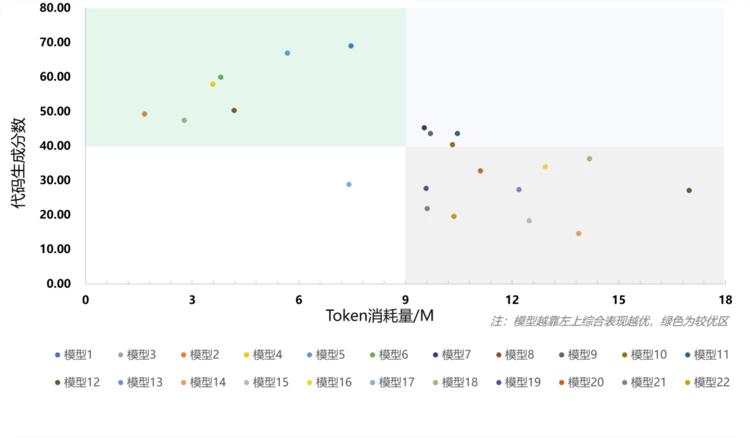
代码生成任务得分与Token消耗关系
测试结果发现:一是复杂任务表现拉开模型能力差距。难度增加时,头部模型表现稳定,部分模型得分明显下降,总分数难以全面反映模型能力。二是生成代码仍需完整的工程验证。生成任务失败主要表现为探索未收敛、仓库集成不匹配及边界场景覆盖不足。
子任务2 代码问题解决任务测试结果
代码问题解决任务考察模型能否根据问题描述和代码上下文准确定位缺陷,完成有效修复并通过测试验证。
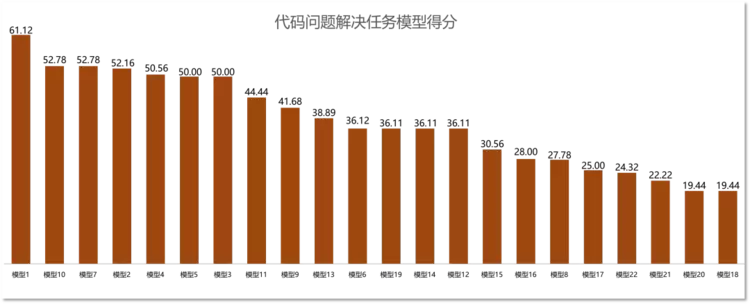
代码问题解决任务模型得分
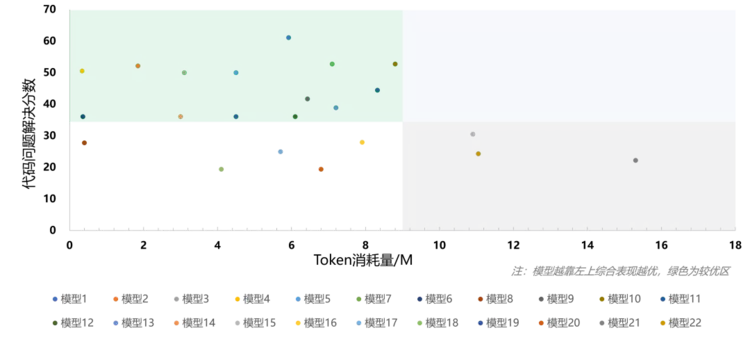
代码问题解决任务得分与Token消耗关系
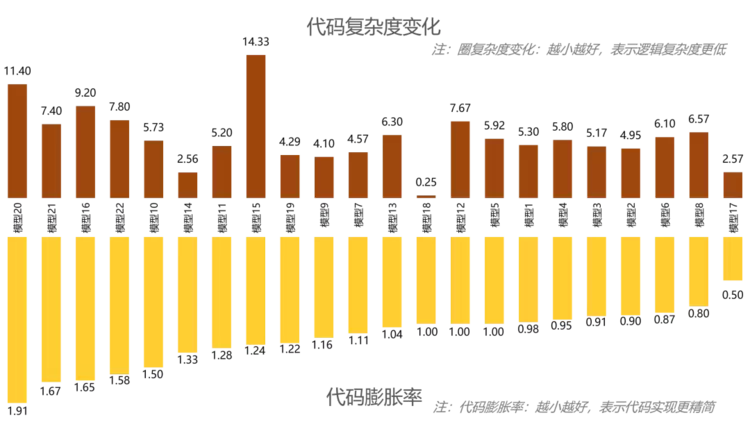
解决成功结果的代码复杂度和膨胀率
测试结果发现:一是修复效果与资源消耗并非简单正相关。高消耗未必带来更优修复效果,需兼顾修复效果与资源效率。二是任务成功仍需关注生成代码质量。部分结果存在代码膨胀或逻辑复杂问题,需关注可维护性。三是未成功修复的结果也可能提供有效的问题定位和修改线索,但不同模型的辅助价值存在明显差异,参考价值评分从4.1分到8.0分不等。
子任务3 单元测试任务测试结果
单元测试任务考察模型能否针对复杂函数生成可运行的测试用例,通过构造合理的测试输入覆盖关键代码路径,并设计有效断言校验执行结果、发现代码缺陷。
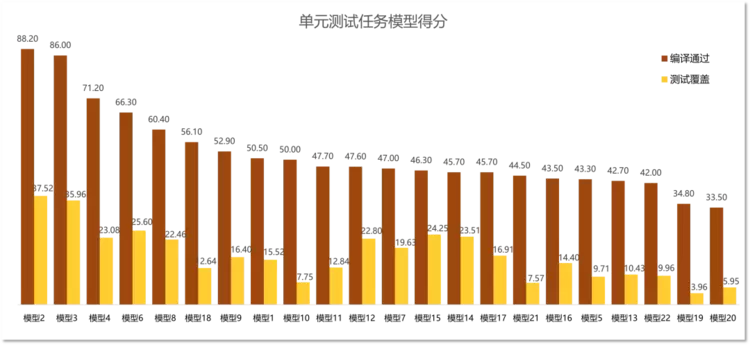
单元测试任务模型得分
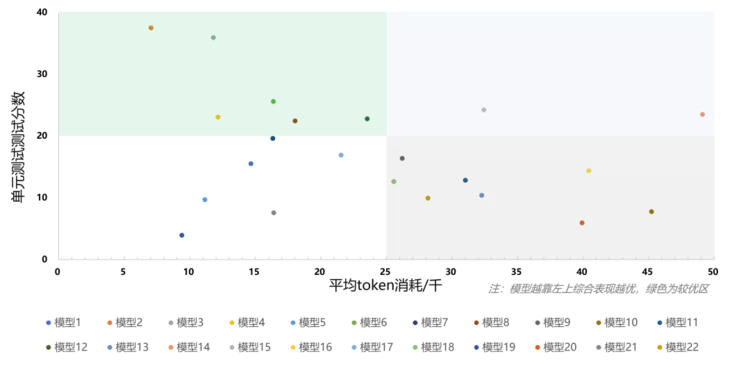
单元测试任务得分与Token消耗
测试结果发现:一是复杂路径覆盖不足。分支、边界等路径覆盖不充分,控制流理解与测试输入构造能力仍需提升。二是项目适配不足是编译失败主因。错误集中于API、符号及类型与项目不匹配,纯语法错误较少。三是指令遵循不足影响用例可用性。部分结果将解释文字或格式标记混入源代码,导致编译失败。
子任务4 研发问答任务测试结果
研发问答任务考察模型能否理解真实代码库的工程机制,查找有效代码证据,对研发问题给出准确、完整且有依据的回答。
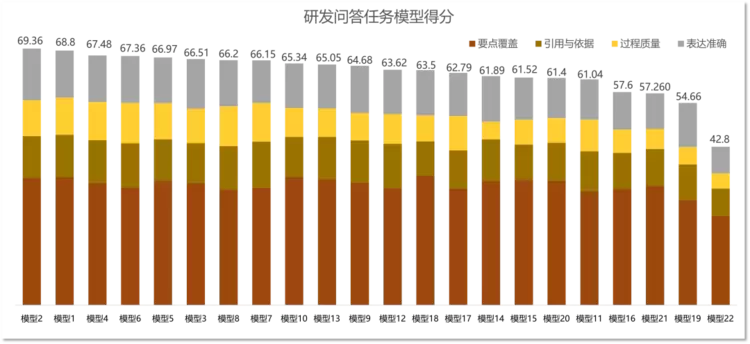
研发问答任务模型得分
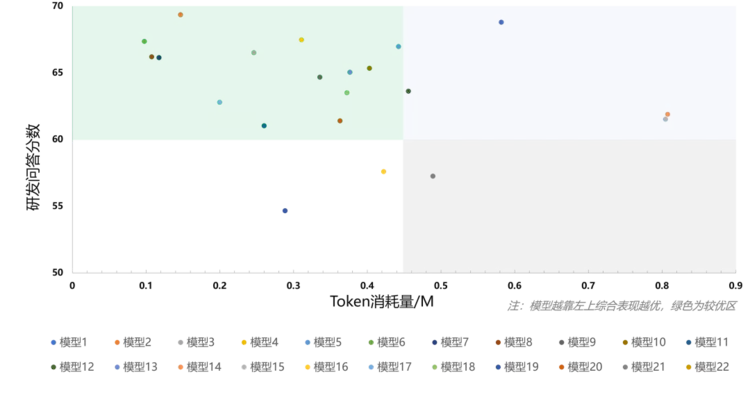
研发问答任务得分与Token消耗
测试结果发现:一是头部模型得分接近、优势各异。在引用依据、过程质量和表达准确性等方面各有侧重。高效检索与验证有助于提升回答质量。二是高分低消耗模型能快速聚焦关键疑点,通过针对性分析与验证,形成准确、有依据的结论。
未来,中国信通院将持续推进大模型代码能力基准测试研究。一是完善任务体系,拓展端到端应用构建、长程自主研发等任务,健全动态校准、污染核查和基准退役机制;二是深化能力诊断,分析模型短板、成因与边界,支撑模型优化、工具选型和研发应用;三是开展分层评价,分别评估模型原生代码能力与代码智能体实际编码能力;四是推进Harness框架标准化评测,纳入国内代表性框架,通过固定模型或框架开展对比,区分模型能力与框架效果。
相关文章
- 中国信通院发布“方升-Code”V2.0基准测试体系及最新基准测试结果
- 中国信通院张海懿:统筹规划网络运载力,加快推进算网融合服务
- 记忆能力达4+级!中兴通讯Co-Claw智能体首批通过中国信通院可信AI认证
- 首家!九章云极通过中国信通院智算云平台能力评测
- 中国信通院副院长敖立:实施“宽带提质”专项工作 推动提升宽带网络用户体验
- 权威发布 | 新华三联合中国信通院发布《ICT智能体的技术突破与建设指南》
- 南凌科技“SD-WAN跨境组网”通过中国信通院评审/评估/认证
- 首家!九章云极Alaya Token通过中国信通院高质量Token云服务能力评估
- 2026中国互联网大会丨中国互联网协会与中国信通院发布首批互联网智能体登记可信清单
- 中国信通院权威发布:网易四项成果入选国家级智能体创新汇编
- 用友YonClaw通过中国信通院“企业级类Claw智能体安全能力评估”
- 业内首家通过中国信通院可信数据空间专项评测:趣链科技做对了什么?
- 中国信通院副院长敖立:深化“千兆普及”,推进“万兆启航”,加快我国宽带网络提质升级
- 中国信通院:3月国内手机出货量2115.0万部,同比下降7.1%
- 助力行业标准化建设,Sigmob入选「中国信通院铸基计划·技术百人专家」
- 中国信通院与腾讯云联合发布“云上养虾安全七条”
AI企业
更多>>
AI硬件
更多>>AI产业
更多>>AI技术
更多>>- 华为×华东师大联合研发时序预测基础模型,登顶国际权威时序测评双榜单
- 阶跃这次够狠:AA 全球开源前二,价格打到 Claude 的 1/8
- 科大讯飞发布Spark-Audio-1.0-Preview,全国产语音基座大模型实现从“听清”到“听懂”
- 全球最强开源模型 Kimi K3 发布,参数规模 3 万亿,真的是强!
- 范式变革!东软发布AI原生软件工程白皮书,重构软件产业底层逻辑
- KAT-Coder-Pro V2.5正式发布:从“写代码”迈向“做工程”,Agentic能力全面升级
- 自变量机器人王昊:训练世界模型需付出“时间税”,解决模态对齐是当务之急
- 腾讯发布CodeBuddy Security,用AI Agent实现更高效的代码审计