MOSS-Transcribe-Diarize 是什么?一文看懂这款多说话人语音识别模型
2026/11/01 21:33AI云资讯13167
整理多人会议的录音,最费劲的往往不是把话记下来,而是分清每句话是谁说的、什么时候说的。几个人轮流发言,有人中途插话,有时两三个人还会同时开口。常见的做法是把任务拆给三个模型:语音识别转文字,说话人分离区分是谁在说,时间对齐标出每句话的起止时间。录音一长,还要先切成小段分别处理,最后再拼回去,拼接处的错漏只能靠人工逐段校对。
模思智能与 OpenMOSS 推出的 MOSS-Transcribe-Diarize(MOSS 多说话人语音转录模型)把这几步合并成一步完成。它是一个端到端模型,输入整段录音,就能直接输出带时间戳和说话人编号的文字稿。这个系列目前有两个版本:开源的 MOSS-Transcribe-Diarize 0.9B,以及能力更强的旗舰版 MOSS-Transcribe-Diarize Pro。
MOSS-Transcribe-Diarize 0.9B 于 2026 年 7 月 9 日开源,以 Apache-2.0 许可公开代码和权重。它的参数规模为 0.9B,支持 128K token 上下文,约 90 分钟的录音可以一次处理完。在多说话人会议测试集 AISHELL-4 上,它的字符错误率(CER)为 14.84%,计入说话人归属的错误率(cpCER)为 15.83%,两项成绩都好于官方对比的豆包、ElevenLabs、Gemini 等 5 个第三方系统。它还获得了 INTERSPEECH 2026 第二届 MLC-SLM 挑战赛 Task 1(多语种对话语音说话人分离与识别)第一名。
旗舰版 MOSS-Transcribe-Diarize Pro 的准确率更高。在官方公布的四个测试集上,它的成绩都好于 0.9B,其中 AISHELL-4 上的 cpCER 从 15.83% 进一步降到 14.02%。
一、MOSS-Transcribe-Diarize 的定义、版本与团队
MOSS-Transcribe-Diarize 是一款端到端的多说话人语音识别模型,要回答的是一段录音里“谁在什么时候说了什么”。名字中的 Diarize 取自 Speaker Diarization(说话人分离),即判断录音中每段语音分别属于哪位说话人。
两个版本的定位不同:开源的 MOSS-Transcribe-Diarize 0.9B 按官方说明支持 50 多种语言,适合本地部署、二次开发和微调;旗舰版 MOSS-Transcribe-Diarize Pro 不开源,通过 MOSS API 以在线服务的形式提供。
MOSS-Transcribe-Diarize 由模思智能与 OpenMOSS 共同推出。OpenMOSS 是上海创智学院、复旦大学 NLP 实验室与模思智能共建的研究团队。在这套产学研合作中,OpenMOSS 承担前沿模型研究与开源发布,模思智能负责工程化、产品落地和商业化,旗舰版 Pro 的在线服务也由模思智能提供。
二、MOSS-Transcribe-Diarize 的核心能力
MOSS-Transcribe-Diarize 具备语音转写、说话人区分、时间戳预测、重叠语音处理和热词增强五项能力,还可以按需标注非语音事件。技术报告开篇用一张能力概览图,把这些特点归纳成四组关键词。
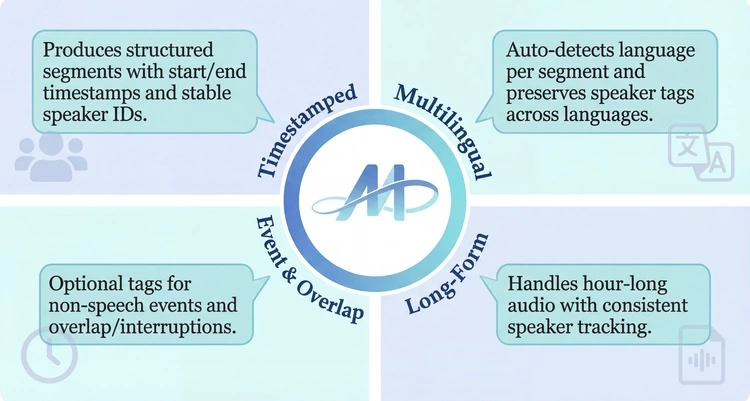
图注:MOSS-Transcribe-Diarize 能力概览:从带时间戳的结构化分段、多语种转写、事件与重叠标注、长音频说话人追踪四个方面概括模型特点
图的四角各对应一组关键词:Timestamped(时间戳)指输出按段组织,每段带起止时间和稳定的说话人编号;Multilingual(多语种)指模型逐段识别语种,语种切换时说话人编号保持不变;Event & Overlap(事件与重叠)指可以按需标注非语音事件、重叠语音和插话;Long-Form(长音频)指模型能处理小时级录音,并持续追踪每位说话人。
转写、说话人与时间戳一次输出
传统方案里,识别、分离、对齐各由一个模型负责,前一环出了错,后一环会跟着出错。MOSS-Transcribe-Diarize 把三项任务统一为一个生成任务,一次输出就同时给出时间、说话人和文字。
输出按段排列,每段依次包含开始时间、说话人编号、文字和结束时间,例如“[1.11] [S02] Morning, guys! [1.34]”和“[1.20] [S03] Hi, everyone! [1.44]”。这两段发言在 1.20 到 1.34 秒之间重叠,模型仍把两人的话分别记录下来。真实对话中,抢话、插话和附和都会造成这样的重叠,MOSS-Transcribe-Diarize 在训练时专门模拟了这类情况。
模型输出的是一段连续文本,时间以秒为单位。仓库自带的解析函数可以把它拆成开始时间、结束时间、说话人和文本四个字段。说话人用匿名编号区分,同一个人在整段录音中编号不变,接入业务系统时只需把编号对应到参会人姓名。
约 90 分钟长音频整段处理
长录音如果切片处理,切口处的句子容易被截断,同一个人在不同片段里可能被分到不同编号,拼接后的时间戳也可能错位。MOSS-Transcribe-Diarize 可以整段处理长录音,不需要切片,模型在整段录音中持续追踪每位说话人。以开源的 0.9B 为例,它的 128K token 上下文可以容纳约 90 分钟的连续音频。
官方评测中的 AISHELL-4 和 Podcast 都是长音频,并且都按整段处理。AISHELL-4 是 5 到 7 人参与的真实会议,单条平均约 38 分钟;官方自建的 Podcast 测试集平均约 44 分钟,最长约 61 分钟,说话人数为 2 到 11 位。
三、MOSS-Transcribe-Diarize 的技术原理
MOSS-Transcribe-Diarize 的思路,是把“谁在什么时候说了什么”整体当成一段文字来生成。以开源的 0.9B 为例,它由两部分组成:Whisper-Medium 配置的音频编码器负责“听”,Qwen3-0.6B 风格的因果解码器负责“写”。
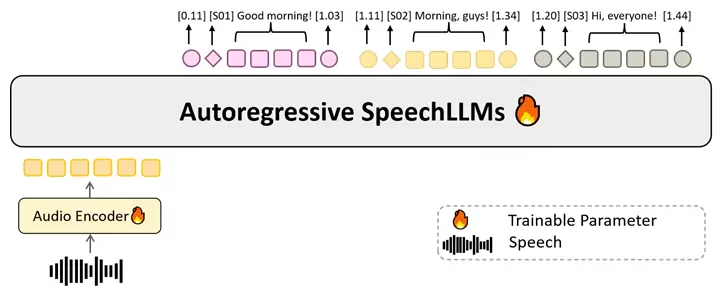
图注:MOSS-Transcribe-Diarize 模型架构:音频编码器提取声学特征,自回归语音大模型直接输出带时间戳和说话人编号的转写序列
架构图从左下角读起。输入的音频波形先经音频编码器(Audio Encoder)转成一串声学特征,这些特征在时间上合并压缩到原来的四分之一,再经 MLP 适配器转换,送进上方的自回归语音大模型(Autoregressive SpeechLLMs),也就是因果解码器。解码器逐段写出带时间戳和说话人编号的结果。右下角的图例表明,编码器和解码器都参与训练。
时间怎么表示,是这套方案的关键。如果只让模型根据特征在序列里的位置去推算时间,录音越长越容易算偏。MOSS-Transcribe-Diarize 的做法是把格式化的时间戳文本直接插在各段音频特征之间,相当于给模型配了一把刻度尺。时间变成了模型能直接读写的文字,小时级录音也能得到准确的段级时间戳,说话人归属同样保持稳定。
训练数据分两部分:一部分是从互联网收集的多语种真实对话,覆盖不同的口音、声学环境和领域,让模型熟悉自然的说话方式;另一部分是按属性控制生成的模拟对话,专门用来补充难例。每段模拟对话有 2 到 12 位说话人,既有轮流发言,也有语音重叠,重叠最长可达两段语音中较短一段的 80%。音频中还叠加了真实噪声和混响,信噪比控制在 0 到 15 dB,用来模拟多人抢话、环境嘈杂等场景。
四、MOSS-Transcribe-Diarize 的评测表现
从官方评测和公开比赛的结果看,MOSS-Transcribe-Diarize 在多说话人转写上表现突出。官方在会议、多嘉宾播客和影视片段等四个测试集上做了对比,MOSS-Transcribe-Diarize 0.9B 的 cpCER 都好于参与对比的第三方系统,旗舰版 Pro 又好于 0.9B。在第三方组织的 MLC-SLM 挑战赛中,0.9B 也获得了多语种对话语音说话人分离与识别任务(Task 1)的第一名。
AISHELL-4 会议转写
AISHELL-4 是公开的真实会议室数据集,采用远场录音,语音重叠较多。官方在这个数据集上用三项指标做对比,数值都是越低越好:CER 是字符错误率,只衡量文字是否转写准确;cpCER 先把每位说话人的话分别拼接再计算错误率,同时考核内容和说话人归属;Δcp 是两者之差,表示加入说话人归属后多出的错误,数值越小,说明说话人区分越稳定。
参与对比的有 5 个第三方系统,包括豆包语音识别模型、ElevenLabs、Gemini 2.5 Pro 和 Gemini 3 Pro 这 4 个闭源商用系统,以及开源的 VibeVoice ASR。MOSS-Transcribe-Diarize 0.9B 在三项指标上的成绩都好于这 5 个系统:
CER 为 14.84%,领先成绩第二的豆包(18.18%)3.34 个百分点;
cpCER 为 15.83%,领先成绩第二的 VibeVoice ASR(24.99%)9.16 个百分点;
Δcp 为 0.99,VibeVoice ASR 以 3.59 位列第二,4 个闭源商用系统都在 4.68 以上。
Δcp 不到 1,说明计入说话人归属后,错误率几乎没有增加。在平均约 38 分钟的会议录音中,模型能够较稳定地区分每位说话人。
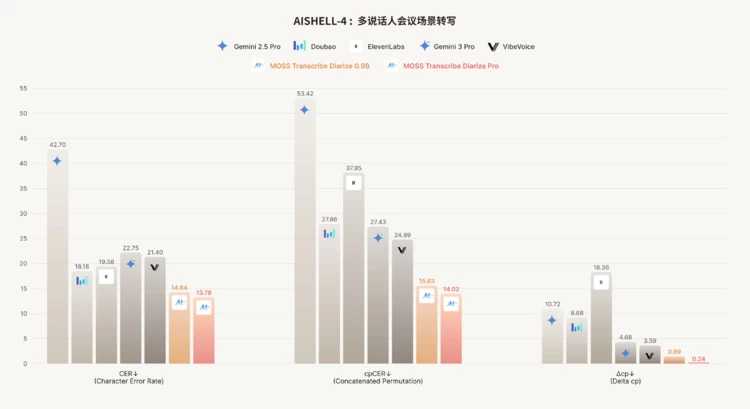
图注:AISHELL-4 多说话人会议转写:7 个系统在 CER、cpCER、Δcp 三项指标上的对比,数值越低越好
这张对比图把三项指标分成三组,每组左侧五根灰色柱是对比系统,橙色柱是 MOSS-Transcribe-Diarize 0.9B,最右侧的红色柱是旗舰版 MOSS-Transcribe-Diarize Pro。柱子越短,成绩越好。三组中两根 MOSS 柱子都短于所有对比系统,Pro 的柱子又比 0.9B 更短,对应的 CER、cpCER、Δcp 分别为 13.78%、14.02% 和 0.24。
四个测试集的 cpCER 对比
官方还在 Alimeeting 会议集、多嘉宾长播客 Podcast 和语音重叠较多的影视片段 Movies 上做了测试。下表对比 MOSS-Transcribe-Diarize 0.9B 与 4 个第三方模型的 cpCER,这 4 个模型在四个测试集上都有公开成绩:
模型 | AISHELL-4 | Alimeeting | Podcast | Movies |
MOSS-Transcribe-Diarize 0.9B | 15.83 | 22.17 | 7.37 | 12.76 |
Doubao | 27.86 | 37.57 | 10.54 | 30.88 |
ElevenLabs | 37.95 | 36.69 | 11.34 | 17.85 |
VibeVoice ASR | 24.99 | 29.33 | 48.30 | 42.54 |
Gemini 2.5 Pro | 53.42 | 41.64 | 10.23 | 24.15 |
表注:表中数值为 cpCER(%),越低越好。数据来自 MOSS-Transcribe-Diarize 官方评测,其中 Podcast、Movies 为官方自建测试集。Doubao 即豆包语音识别模型。
四个测试集上,MOSS-Transcribe-Diarize 0.9B 的 cpCER 成绩都排在表中首位,领先最多的是长会议 AISHELL-4。在 Alimeeting 上,它领先成绩第二的 VibeVoice ASR(29.33%)7.16 个百分点;在 Podcast 和 Movies 上,成绩第二的分别是 Gemini 2.5 Pro(10.23%)和 ElevenLabs(17.85%)。
MLC-SLM 挑战赛 Task 1 第一名
第二届多语种对话语音语言模型挑战赛(MLC-SLM)是一项公开比赛,与 INTERSPEECH 2026 同期举办,由西北工业大学、南京大学、南洋理工大学、台湾大学、上海交通大学等高校的学者以及 ELRA、Nexdata、华为等机构联合组织。据组织方总结,各任务共有 91 支队伍参赛。
Task 1 的任务是多语种对话语音说话人分离与识别,覆盖英语、法语、德语、日语、韩语、泰语、越南语、乌尔都语等 14 种语言。榜单按 tcpMER 排名,这项错误率指标在时间约束下同时考核转写内容和说话人归属,数值越低越好。据赛事官网榜单,Task 1 共有 9 支队伍上榜,MOSS-Transcribe-Diarize 0.9B 以 14.93 的 tcpMER 排名第一:
Rank | Username | tcpMER |
1 | MOSS Transcribe Diarize | 14.93 |
2 | trasr | 15.41 |
3 | Cake By VPBank | 15.84 |
4 | HINTT | 16.27 |
5 | roysun2006 | 16.73 |
6 | SQZ | 17.97 |
7 | xdynamics | 18.44 |
8 | SMIIP Lab | 19.97 |
9 | fangshuming | 50.23 |
表注:tcpMER 越低越好。数据来自 MLC-SLM 挑战赛官网公布的 Task 1 成绩表。第一名 MOSS Transcribe Diarize 即 MOSS-Transcribe-Diarize 0.9B。
五、开源 0.9B 与旗舰版 Pro 的区别
两个版本同属 MOSS-Transcribe-Diarize 系列,都能一次输出带说话人编号和时间戳的文字稿,区别主要在准确率和使用方式上。
旗舰版 MOSS-Transcribe-Diarize Pro 基于更大规模的模型能力,在说话人区分、上下文理解、转写一致性和多语言能力上都有增强。在官方评测的四个测试集上,Pro 的 cpCER 全部好于 0.9B:
测试集 | MOSS-Transcribe-Diarize 0.9B | MOSS-Transcribe-Diarize Pro |
AISHELL-4 | 15.83 | 14.02 |
Alimeeting | 22.17 | 13.94 |
Podcast | 7.37 | 6.97 |
Movies | 12.76 | 11.78 |
表注:表中数值为 cpCER(%),越低越好。数据来自 MOSS-Transcribe-Diarize 官方评测。
四个测试集中,Alimeeting 会议集上的差距最大:Pro 的 cpCER 为 13.94%,领先 0.9B(22.17%)8.23 个百分点。在 AISHELL-4、Podcast 和 Movies 上,Pro 分别领先 1.81、0.40 和 0.98 个百分点。
使用方式上,0.9B 开放权重,可以部署在自己的服务器上,录音数据不出内网,也可以用自有数据微调后集成到产品中。体量较小,也让它在显存占用、推理速度和部署成本上更有优势。Pro 则不开源,通过 MOSS API 以在线服务的形式提供,用户无需自备算力。
Pro 的能力也已用在模思智能自家的产品上。语音输入产品 MosMos 基于 MOSS-Transcribe-Diarize Pro,可以免费使用。在会议场景中,它能区分每位发言人,生成完整的文字稿,并整理出会议要点和待办事项;日常输入时,在任意文本框里说话就能转成文字,还可以按需润色。
六、获取、部署与开发者生态
MOSS-Transcribe-Diarize 0.9B 的权重发布在 Hugging Face 的 OpenMOSS-Team/MOSS-Transcribe-Diarize 仓库,ModelScope 和 AtomGit 上也有同名仓库;推理代码、字幕工具和微调脚本放在 GitHub 的 OpenMOSS/MOSS-Transcribe-Diarize。只想先看看效果,可以在官方在线 Demo 上传音频或视频,单次最长 30 分钟。
本地运行时,官方测试环境为 Python 3.12 和 Transformers 5.x。模型可以直接读取原始音频,视频文件抽出音轨后同样能转写。在一张 NVIDIA RTX 4090 上单路运行,官方测得的生成速度最高约 100 token/s,实时率(RTF,处理耗时与音频时长之比)约 0.017,5 到 10 分钟的音频 30 秒以内就能转完。处理长音频时,记得把生成长度上限(max_new_tokens)调大。
对会议纪要来说,产品型号、客户名称等专有名词一旦写错,影响往往比普通词更大。这时可以用热词增强,在默认的中文提示词末尾加上“热词提示:”,再列出公司名称、项目代号、人名、行业术语等词语,例如:
Plain Text |
热词覆盖不了的业务术语,可以用仓库自带的微调脚本,基于自有数据训练专属版本。做字幕也有现成工具:仓库里的字幕 Web 应用支持上传音视频、逐段审阅,并导出 JSON、SRT、ASS 格式字幕,本机装有 FFmpeg 时还能直接生成带字幕的 MP4。
需要部署成服务时,官方推荐 SGLang Omni,它提供兼容 OpenAI 的音频转写接口,可以直接返回按说话人分好的段落;服务器是 CUDA 12 环境时,也可以改用 vLLM。生态方面,SGLang 在开源当天就宣布支持,FunASR、视频剪辑工具 FunClip 和面向苹果芯片的 MLX-audio 也陆续接入,使用者可以按自己的技术栈选择部署方式。
七、MOSS-Transcribe-Diarize 总评与推荐
MOSS-Transcribe-Diarize 的核心价值,在于把“谁在什么时候说话”的判断和文字转写放进同一次生成中完成。以开源的 0.9B 为例,约 90 分钟以内的会议可以整段输入,无需切片拼接,说话人编号在整段录音中保持一致,人工校对可以集中在内容本身。
对需要自行部署和二次开发的使用者来说,MOSS-Transcribe-Diarize 0.9B 值得优先考虑。它在官方评测中的成绩好于多款闭源商用系统,还获得了 MLC-SLM 挑战赛 Task 1 第一名。权重可以私有化部署,并附带字幕工具和微调脚本,适合作为会议纪要、访谈整理、客服质检和字幕生成等应用的底座。
旗舰版 MOSS-Transcribe-Diarize Pro 更适合对准确率要求更高、希望通过 API 把转写能力集成到业务系统中的团队。它在官方评测中的整体表现好于 0.9B,通过 MOSS API 即可接入。
只想用会议转写和说话人区分功能、不打算部署模型也不想编写代码调用 API 的用户,可以直接使用 MosMos。它基于 MOSS-Transcribe-Diarize Pro,安装客户端后就能把会议录音整理成带说话人的纪要。
关于 MOSS-Transcribe-Diarize 的常见问题
MOSS-Transcribe-Diarize 和普通语音识别模型有什么不同?
普通语音识别模型主要把语音转成文字,说话人区分和时间对齐通常需要另接模块。MOSS-Transcribe-Diarize 在同一次生成中同时输出文字、说话人编号和每段话的起止时间,更适合处理多人对话录音。
MOSS-Transcribe-Diarize Pro 和开源的 0.9B 是什么关系?
两者同属 MOSS-Transcribe-Diarize 系列。MOSS-Transcribe-Diarize 0.9B 公开代码和权重,可以本地部署和微调,在官方评测中的成绩好于豆包、ElevenLabs、Gemini 等商用系统。MOSS-Transcribe-Diarize Pro 是能力更强的旗舰版,在四个测试集上的成绩都好于 0.9B。它不开源,通过 MOSS API 以在线服务的形式提供。
MOSS-Transcribe-Diarize 能转写哪些语言的录音?
按官方说明,开源的 MOSS-Transcribe-Diarize 0.9B 支持 50 多种语言。公开评测覆盖会议、多嘉宾播客和影视片段,其中影视片段包含中文、英语、韩语、日语和粤语。它还在覆盖 14 种语言的 MLC-SLM 挑战赛 Task 1 中获得第一名。
在哪里可以试用 MOSS-Transcribe-Diarize?
可以直接使用官方在线 Demo,上传音频或视频即可看到带说话人和时间戳的转写结果。如果想在本地运行,可以从 Hugging Face 或 ModelScope 下载权重,按 GitHub 仓库的说明安装。
相关文章
- MOSS-Transcribe-Diarize 是什么?一文看懂这款多说话人语音识别模型
- 从语音识别到意图成稿:讯飞输入法引领语音输入进入第三代
- 十方融海产学研项目通过验收,复杂场景AI语音识别技术取得突破性进展
- 图像处理、语音识别的经验案例:西安羲和
- Scale AI语音识别技术落地微软,AI语音领域再添里程碑
- 天玑9400首发端侧AI语音识别技术,打造《破碎之地》随行AI NPC
- 语音识别上难度 讯飞输入法免切换识别多语种多方言不迷糊!
- 量身定制 精准识别,标贝科技语音识别定制方案助力企业智慧升级
- vivo携手昆仑芯、wenet助力提升语音识别效果与性能,共建开源生态
- 说话秒变笔记!讯飞语记能“连续语音识别速记”
- 出门问问联合发布全球最大多领域中文语音识别数据集WenetSpeech
- 从语音识别到AI拍摄,骁龙人工智能算力覆盖手机体验方方面面
- AI助手查余额,思必驰语音识别支持10多种方言
- 197亿美元现金!微软宣布收购语音识别巨头Nuance
- 谷歌发布新一代定向人声分离系统,2.2MB模型提升设备端语音识别
- 小米MIUI新增字幕模式,语音识别更加懂你