AI算力竞赛时代的PCIe:Gen 6只是Gen 5的“平滑升级”?
2026/11/18 13:16AI云资讯13328
乍看之下,PCI Express 6.0(或称PCIe Gen 6.以下简称PCIe 6)虽然相较PCIe 5的带宽翻了倍,但奈奎斯特频率(Nyquist Frequency)和波特率(Baud Rate)没变,已有电路板、连接器和封装设计似乎可以沿用,所以PCIe 6相较PCIe 5是一次“平滑升级”——但实际情况果真如此吗?
PCIe 6是PCI-SIG(外围部件互连专业组)于2019年中宣布启动开发,并于2022年初正式发布的计算机内部高速互连标准——传输速率增至64 GT/s,x16配置下单向理论原始带宽为128 GB/s;采用四电平脉冲幅度调制(PAM-4)与低延迟前向纠错(FEC)方案。实际上,从此前的不归零码(NRZ)转向PAM-4调制方式,要在同样32 GBd下承载两倍的数据,代价是理想等间距条件下约9.5 dB的判决幅度裕量损失。
从这个角度来看,PCIe 6的硬件挑战由通道延伸至收发器。换句话说,产业界针对PCIe 6的竞争分水岭已经不是“能否达到64 GT/s”,而是“还剩多少裕量”。在这个问题上,芯耀辉的PCIe 6 PHY IP交出了一份答卷:据芯耀辉介绍,该IP“首次流片即成功”,且“具备充足的设计裕量”。
借助芯耀辉的PCIe 6 PHY产品,可以具体观察PCIe 6的难点根源及应对策略。
PCIe 6在AI基础设施里的位置
理解PCIe的演进,首先要看它在AI基础设施中的位置。PCIe 6的量产导入,恰逢AI基础设施的大规模建设期,它的职能已经从简单的外围总线,变成了在越来越多的系统里承担部分scale-up职责的高速互连,用于连接基础设施内的GPU、加速器、CXL内存池及存储设备。互连带宽也因此直接影响这些设备之间的数据交换效率。
谈到“超节点”“高速互连域”“scale-up”这些概念,很多人首先想到的是NVLink这类私有链路。这类私有链路的每GPU带宽的确可以达到PCIe的数倍。但集群的互连有着多样化的发展路线——不同的芯片及系统企业有不同的互连方案。
PCIe的独特地位就在于,它通常被当作通用通路和标准化的互连解决方案,是不绑定任何一家厂商的选择。PCIe的带宽不是最高的,却几乎成为了每颗关键芯片I/O的必选项——一颗AI加速器可以不用NVLink,却很难绕开PCIe。
作为计算机内部连接硬件组件的高速标准,PCIe不仅是CPU、GPU、网卡、DPU、SSD之间的通用通路;在某些系统中,PCIe现在就是scale-up的主干道:用PCIe Switch把一组加速器连成一个域,是超节点的一种可行架构,规模从8卡、16卡扩展至数十卡。
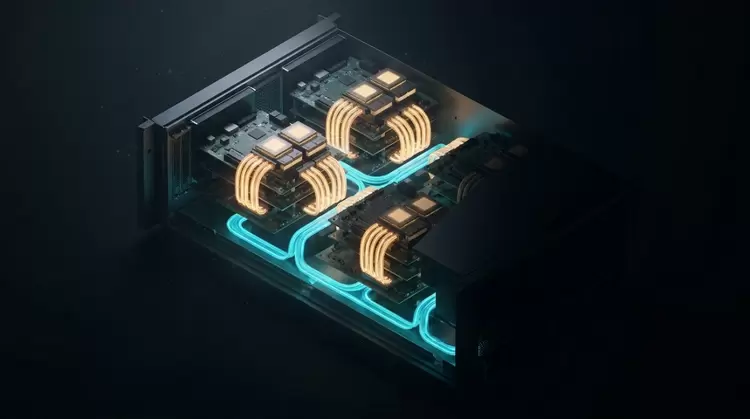
图1:用PCIe Switch将多块加速卡连成一个互连域(示意图)
随着智能体应用的发展,上下文长度不断增加,键值缓存(KV Cache)的容量需求也随之上升,内存、存储变得愈发重要,于是CXL成为了AI基础设施内的热门话题:内存池化、内存扩展,听起来是架构层面的变革,但落到物理层,复用的仍是PCIe PHY——CXL 3.x的64 GT/s就直接复用了PCIe 6的PAM-4 PHY。CXL在AI服务器中的渗透率越高,需要PCIe PHY的场合就越多。
PCIe 6及其后续版本在现代计算系统中的重要性,前所未有。当服务器或机柜内与AI加速卡交换数据的网卡、DPU、SSD越来越多,对互连通路造成的压力就越大——互连一旦成为瓶颈,计算资源的利用率就会下降。PCIe 6的速率翻倍正是诞生在这样的时代背景下。
更高的速率需要付出代价
只不过PCIe 6速率翻番是需要付出代价的。PAM-4的本质,是在每个符号周期内,以四种电平之一表示数据。它没有提高符号速率,只是让每个符号多携带1 bit数据。而NRZ只有一条判决门限、两个电平,理想情况下两电平之间的间距等于总摆幅;PAM-4有三个门限、四个电平,理想等间距时,相邻电平间距各占总摆幅的1/3——在同样的摆幅与符号速率下,判决的幅度裕量便减少约9.5 dB。
而PCIe 6的传输通道条件并没有变好,奈奎斯特频率仍为16 GHz,原有电路板、连接器与封装能否沿用,要看具体通道的损耗和反射。规范虽将标称通道损耗预算从PCIe 5的36 dB收紧到32 dB,但这4 dB远不足以抵消约9.5 dB的损失,接收机要在更紧的预算里做判断。所以PCIe 6从来不是“把PCIe 5调快一点”那么简单。
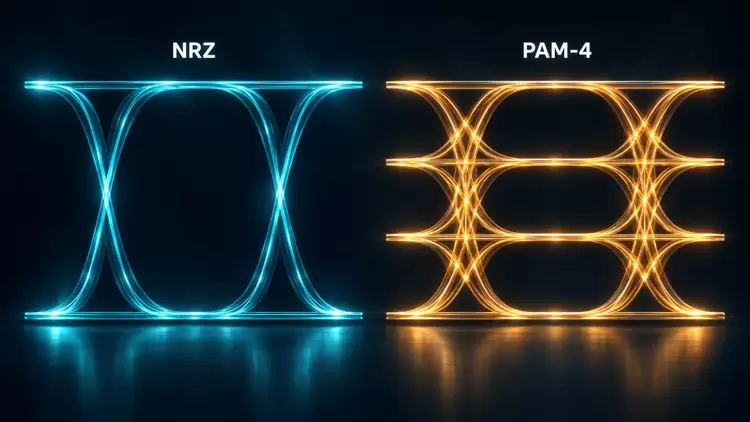
图2:NRZ只有一只“眼”,PAM-4要在同样的摆幅内分出三只“眼”(示意图)
于是FEC配套出现。更准确的说法是:轻量级FEC是PCIe 6在64 GT/s下控制链路错误率的一项关键机制。对于纠错能力范围内的错误,接收端可就地纠正,无需重传——PCI-SIG给出的取舍是,宁可承担小概率下FEC纠错失败带来的重传代价,也要控制正常传输路径上的固定纠错时延。
只不过FEC可以降低残余误码率,但接收端仍须具备足够的判决裕量。PCIe 6规范把考核点放在了FEC之前,规范以首比特误码率(FBER)描述突发错误的起始概率,设计目标为10⁻⁶量级,再由FEC推到链路层可用的水平。也就是说,FEC处理的是错误发生的概率问题,不是弥补信号眼图裕量的不足。PCI-SIG明确了不把FEC当作获取通道编码增益的手段,对更长的通道,可采用重定时器(Retimer)将链路分段,各段仍需分别满足电气要求。
与此同时,FEC要工作还有个前提:数据必须是定长的块。PCIe 6因此引入了FLIT模式,把所有数据装进固定256字节的容器,因为算校验必须知道块在哪里结束。这里藏着PCIe 6标准更深的变化:第一次把纠错搬进物理层。规范的分工从此变成三级——物理层用FEC纠错,链路层用CRC检错,CRC检出的残余错误数据再通过重传恢复。PHY因此需要相应的数字处理逻辑。
而接收机部分的变化最彻底,因为PAM-4改变了接收端的电平判决条件。PCIe 5及更早的版本,接收端可以用限幅放大器,将信号削顶,只保留判决所需的高、低电平信息——对两电平来说没有损失,判断只需要一个门限;但这对四个电平而言就不行了。
PAM-4要求接收机放大时不压缩波形,保持四个电平的等间距。针对40 dB量级的通道损耗,一种实现路径是采用线性前端保留电平信息,再将波形数字化,交由数字信号处理器(DSP)均衡和判决。
因此更多代价随之而来:数字化要采样,采样要时钟,DSP要算力;而PCIe对延迟极其敏感,DSP流水线每增加一级,处理时延也会相应增加。所以在PCIe 6的PHY设计之中,DSP时钟频率与流水线深度需要结合时延和功耗预算确定。
除了接收端,PAM-4同样改变了发送端的考核方式:PCIe 6的发送端一致性测试里新增了RLM和SNDR两个指标,它们考察四个电平离开芯片时的间距是否均匀,以及输出波形受噪声和失真的影响程度。如果信号在源头就偏了,后面所有均衡都只是在补偿一个错误。
这又带来一个实现上的连锁问题。要对付封装和板子上的损耗与反射,往往需要增加均衡抽头(tap);但模拟域里做均衡,tap的权重由电阻和电流的比例决定,多一个tap就多一份面积、功耗和温漂。
总的来说,PCIe 6的通道没变好,理想判决幅度裕量减少约9.5 dB,FEC前的错误概率成为关键指标;接收机要对采样后的信号进行数字均衡,发送端则背着更严的线性度指标和更大的tap预算。在给定通道条件下,收发器的设计直接影响最终能留下多少裕量。
收发器里的四道关口
这些约束如何落实到收发器设计中?芯耀辉的PCIe 6 PHY IP可以作为样本来解答该问题:它的架构选择与对应的优势,落在信号必然要经过的四个位置上。
首先是发送端:先补偿,再发送。这里采用的是DSP与数模转换器(DAC)的组合。PAM-4要产生四个电平,用模拟电流源叠加也能做,但tap的权重就固定在电阻和电流比里——做多了面积和功耗就上去,还会随工艺和温度漂。把均衡搬到数字域,先算出预失真的波形,再交给DAC变成模拟信号,tap的数量就基本只受算力和功耗约束。
PCIe 5的发送端前馈均衡是3个tap,PCIe 6规范把这一项扩到了4个;芯耀辉的实现提供8个抽头,前游标(pre-cursor)和后游标(post-cursor)的个数可自由分配,另外还有1个浮动抽头(floating tap)。
为什么需要多这一倍?因为每个tap只能瞄准一个延迟位置,而损伤的位置是分散的。封装和PCB带来的不只是损耗,还有反射;反射落在时间轴上的位置由物理尺寸决定——基板走线往返多长、过孔多深,回声就在多远的延迟上出现。4个tap只能覆盖4个位置,超出覆盖范围的“回声”便难以得到针对性补偿。
还有个更实际的原因:封装与电路板由客户设计,基板选型、板层数和走线长度因项目而异。Tap预算多一倍,买到的其实是容错空间——客户在板材选择和布线设计上有更大的余地。所以芯耀辉表示,低成本封装也能覆盖:消费类产品常用的FCCSP封装,其信号完整性问题同样可以靠这套tap余量来覆盖。
其次是接收前端:不能压缩波形。限幅放大器在PAM-4上失效,这一级必须换成线性前端。芯耀辉用的是gm-TIA架构的模拟前端(AFE)——跨导把电压变成电流,跨阻再变回电压,本质是一个增益可控、带宽较宽且能保持线性工作的放大器。芯耀辉介绍,这颗AFE在获得高频补偿的同时,输出线性度仍能保证30 dB以上。
AFE要在高频段给出额外增益,才能把被通道损耗的高频分量补回来,而抬高增益本身就会把波形推向压缩区——高频补偿和线性度天然是一对矛盾。能在补高频的同时保住线性度是有难度的。而波形一旦在这里被压缩,ADC采到的就是失真的信号,后级DSP也难以恢复原始的电平间距。
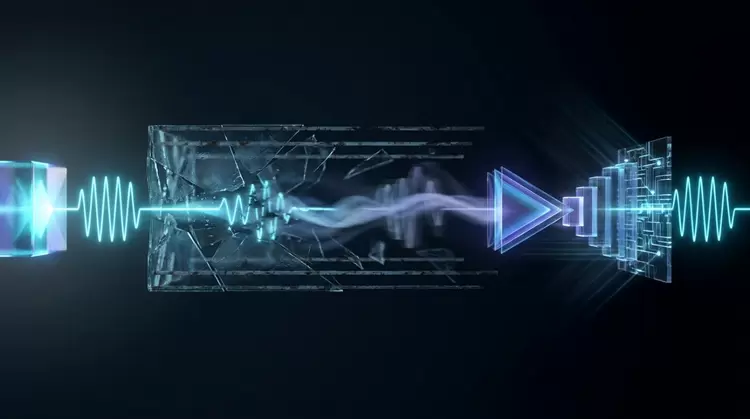
图3:信号经高损耗通道衰减后,由接收端线性放大并数字化处理(示意图)
再者是ADC:交替采样,重建波形。芯耀辉用的是16 GHz、7 bit的TI-ADC(时间交织ADC)。为什么要交织?因为在32 GBd下,若按每个符号采样一次,总采样率为32 GS/s,单个子ADC难以兼顾速率与精度,时间交织架构让多个子ADC轮流采样再拼起来。代价是子ADC之间的失调、增益、时序失配会在带内留下杂散,恰好落在信号所在的位置。7 bit对应128个理想量化等级,而高频下有效位数会退化,实际能守住多少,取决于失配校准后的残余误差。
最后是DSP:算得回来,还要算得快。数字化之后是均衡,芯耀辉在接收端用前馈均衡(FFE)加判决反馈均衡(DFE)的自适应滤波器,共20个tap,覆盖40 dB以上的链路插损。FFE能同时处理前、后游标干扰,但会把高频噪声一起放大;DFE通过反馈抵消后游标干扰,可避免相同补偿量下线性均衡带来的高频噪声增强,适于补偿较长的后游标拖尾,但无法补偿前游标干扰。两者在此设计中互为补充。PCIe 6规范的标称通道损耗为32 dB,“覆盖40 dB”意味着客户可以用损耗很高的板子、封装和连接器组合,带来了设计自由度。
另一头是速度。芯耀辉的DSP工作频率为2 GHz,芯耀辉称这是当前工艺下后端实现的极限。DSP的频率对应一个重要指标:延迟。DSP每多跑几个周期,补偿就滞后几分,自适应跟踪的速度也受制于此。推到工艺极限,换来的就是缩短滞后。
这四道关口的预算其实是同一份:线性度换功耗,位数换功耗和面积,tap换噪声容限,时钟换延迟。提高其中一项指标,往往需要在其余环节作出取舍。而tap则更特殊——它要在发送端和接收端之间再分一次。所以PCIe 6的技术门槛,在于如何在这四个环节之间分配功耗、面积和时延预算。这些取舍是否合理,归根到底要在硅上验证。
硅上见分晓
这四个环节的取舍,最终都要体现为可测量的链路性能。而规范已经把考核点放在FEC之前,首比特误码率目标为10⁻⁶量级——标尺是现成的。设计到底兑现没有,最终需要硅片实测来检验。
先看信号在离开芯片时是什么样子。这组数据来自发送端——电平失配比(RLM)和信号噪声失真比(SNDR)是PCIe 6才纳入一致性测试的两个发送端指标。芯耀辉的PCIe 6 PHY在全工艺角下实测输出摆幅超过930 mV。更大的摆幅本身不提升性能,但它给后面的噪声留出了余量:同样的噪底,信号更高,信噪比就更高。
同一组数据里,PAM-4的RLM仍高于98%——这项指标考的是四个电平在硅上是否还等距,哪个电平被压缩,对应的眼就会先闭上。SNDR实测超过38 dB,反映发送波形中噪声与失真的综合水平。
值得一提的是,“工艺角”描述晶体管等器件的工艺偏差,如快角、慢角;电源电压和温度是另外两个维度,三者合称PVT条件。上述数据取的是各种条件组合下的最差值,而非最优值。
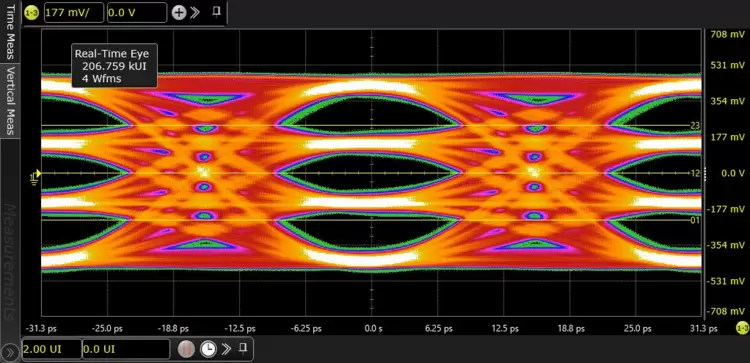
图4:芯耀辉PCIe 6 PHY发送端64 GT/s PAM-4实测眼图(来源:芯耀辉)
接下来看误码率离这道门限有多远。按照PCIe 6协议的要求,在全压力抖动容限测试(JTOL)下,即施加规定的压力抖动条件,首比特误码率(FBER)稳定在10⁻⁷量级——比规范10⁻⁶量级的目标低约一个数量级。
换到板级,评估板(EVB)对传在38 dB链路损耗下,原始误码率达到10⁻9至10⁻10量级。这组数据补充了压力抖动测试的结果,反映的是收发器在特定板级通道上的表现。
还有温度的考验。芯耀辉的PCIe 6产品在EVB对传的基础上叠加温度循环,温度漂移会改变收发器的模拟性能以及通道的损耗曲线,需要有一套复杂的自适应校准算法来修正温度变化带来的性能变化,来达成极低的误码率。
最后是从硅到产品。据芯耀辉介绍,其PCIe 6 IP实现了一次流片成功,第一版硅片实测性能全面超过规范要求,并且满足AI领域对大插损通道、HPC领域对稳定性的严苛需求,当前已经获得多个客户的采用。
规范设定的门限、全工艺角的实测、板级通道的损耗、温度的考验,再加上客户的导入情况——一颗PCIe 6 PHY还剩多少裕量,完全可以从这些数据里读出来。
图5:设计取舍是否合理,最终要在硅上验证(示意图)
机会窗口比想象中窄
从PCIe 1到PCIe 5.多数变化是速率翻倍加上编码调整,骨架基本沿用;PCIe 6则是第一次动到调制方式和纠错机制本身。很显然,PCIe 6不是一次简单的平滑升级——收发器内部被换掉了不少东西:相同的16 GHz奈奎斯特频率、翻倍的传输速率、减少约9.5 dB的理想判决幅度裕量,以及FEC前的误码考核;设计重心从模拟域部分转向了数字域,FEC编解码更是第一次进入物理层。
作为国产AI基础设施生态的一环,芯耀辉的PCIe 6 PHY IP针对的正是这些新增的难题:FEC编解码、数字均衡、更严的发送端线性度指标,都已经在硅上验证过,客户可在已有硅验证的基础上开展集成。
加上LPDDR6、HBM3E、高速SerDes、UCIe等产品线,芯耀辉的接口IP已覆盖AI基础设施建设中从内存吞吐、系统互连到芯粒集成的几条主通道,且均已完成流片验证。对芯片及系统设计企业而言,将更多时间放在能够形成差异化的核心业务上,才有机会真正抓住AI算力竞赛时代的机会窗口。
相关文章
- AI算力竞赛时代的PCIe:Gen 6只是Gen 5的“平滑升级”?
- 格雷希尔携液冷接头亮相CHTF2026,直击AI算力散热连接难题
- AI爆发带火PCB,苏州博视精工与行业伙伴共拓AI算力新蓝海
- 行云科技官宣与火山引擎合作:打通 AI算力生态
- AI算力走向系统级,2026芯和半导体用户生态大会聚焦STCO与AI for EDA
- 科华携内蒙古移动,以液冷CDU及电力方仓助力阿里AI算力部署
- 今日启幕!深圳国际电子元器件展览会群星闪耀,点燃AI算力、液冷散热创新之火
- 浪潮计算机:以协同创新驱动AI算力产业高质量发展
- AI算力下一代芯片会是光吗?智子光垣通用光计算技术曝光
- 端侧AI普及提速!移远通信M.2智能算力板卡QSC600XA-AP,让AI算力“即插即用“
- 中科软携手海光信息,重磅发布EngineerAI算力一体机
- AI算力引燃PCB扩产潮,翼菲科技持续深耕高端电子制造场景
- 全栈智行 焕启新程 | 2026紫光计算机全新战略发布会圆满举办,锚定国产全栈AI算力新赛道
- AI算力进入“效率竞争”新阶段|英博数科亮相2026算力网发展大会
- 华为彭红华:以架构创新与开源生态 共筑Agentic AI算力底座
- 强算·驭电·释冷——论道AI算力下的基础设施变革与重构”科华数据专场论坛成功举办
AI企业
更多>>
AI硬件
更多>>AI产业
更多>>AI技术
更多>>- 云知声 U2-Flash-1118 全新升级:打造国产第一梯队Flash 级别模型中的性价比标杆
- 可灵AI发布全新Kling Image 4.0 AA榜单排名超越Nano Banana
- 探索具身智能新路径,商汤科技实测 GPT-6-Astra
- 华为×华东师大联合研发时序预测基础模型,登顶国际权威时序测评双榜单
- 阶跃这次够狠:AA 全球开源前二,价格打到 Claude 的 1/8
- 科大讯飞发布Spark-Audio-1.0-Preview,全国产语音基座大模型实现从“听清”到“听懂”
- 全球最强开源模型 Kimi K3 发布,参数规模 3 万亿,真的是强!
- 范式变革!东软发布AI原生软件工程白皮书,重构软件产业底层逻辑