硬科技突围:一颗中国芯片,如何破解AI算力的“存储墙”难题?
2026/01/22 11:18AI云资讯14539
在全球人工智能竞赛进入白热化的今天,一股“寂静的洪流”正在算力底座深处涌动。当业界将绝大部分目光聚焦于GPU的算力峰值时,一个更为隐蔽却致命的瓶颈——“存储墙”——正严重制约着千亿级大模型的实际效能。特别是在推理场景中,为注意力机制服务的KV Cache,其巨大的容量需求与严苛的延迟要求,让无数高端GPU的算力在等待数据的过程中被悄然“闲置”。
近日,一家名为绿算技术的中国公司,发布了一款可能改变游戏规则的芯片产品,试图从系统架构的底层,为这道高墙打开一个缺口。
一场瞄准“黄金微秒”的精准狙击
“这不是一次简单的国产替代,而是一次针对AI负载的体系化重构。”绿算技术研发负责人向记者表示。他们推出的,是一款基于自主IP的NVMe over Fabrics桥接芯片(擎翼)原型。
NVMe-oF技术并非新概念,它本是数据中心实现存储资源池化、构建解耦架构的关键。然而,绿算技术的突破在于,首次将这项通用技术,深度锤炼为专为AI大模型KV Cache场景服务的“超高速数据通道”。
其核心目标极其明确:将GPU显存中“住不下”的KV Cache,卸载到由标准NVMe SSD构建的庞大存储池中,并且必须保证访问延迟足够低——低至20微秒以内。这个数字,是确保大模型能够流畅进行实时推理交互的关键阈值。
“业界过去要么选择昂贵到无法规模化的HBM显存扩容,要么忍受软件方案带来的上千微秒延迟。我们的目标,就是在性价比与性能之间,开辟出‘黄金微秒’这一最优路径。”该负责人解释道。
架构重塑:从“缓慢爬楼”到“数据高铁”
为实现这一目标,绿算技术选择了最艰难但最彻底的路径:全硬件卸载。
在传统方案中,一个来自网络的存储访问请求,需要经历网卡、CPU、内存、操作系统协议栈、多次数据拷贝,最后才能抵达SSD,过程如同在城市街道中多次换乘。
而在这颗芯片内部,设计团队构建了一条 “数据高铁”。通过自主设计的七大核心IP核协同工作——从网络包的物理层接收、RDMA协议解析,到NVMe命令转换,直至通过PCIe写入SSD——全部在硬件逻辑中一气呵成,无需CPU介入,实现了零拷贝传输。
尤为关键的是,芯片内集成了一个智能的预取与缓存管理引擎。它能够学习Transformer模型的注意力访问模式,主动预取数据,将看似随机的KV Cache访问,变得更为有序和高效。
实测数据背后的商业价值
根据绿算技术提供的在自研LightBoat 2300加速卡上的测试报告,该原型方案取得了令人瞩目的成绩:489万次4KB随机读取每秒的IOPS,以及高达21.8 GB/s(单卡双100Gbe)的顺序读取带宽。这几乎达到了理论峰值,在实际的业务场景它足以应对数百个并发请求对海量KV数据的随机抓取。
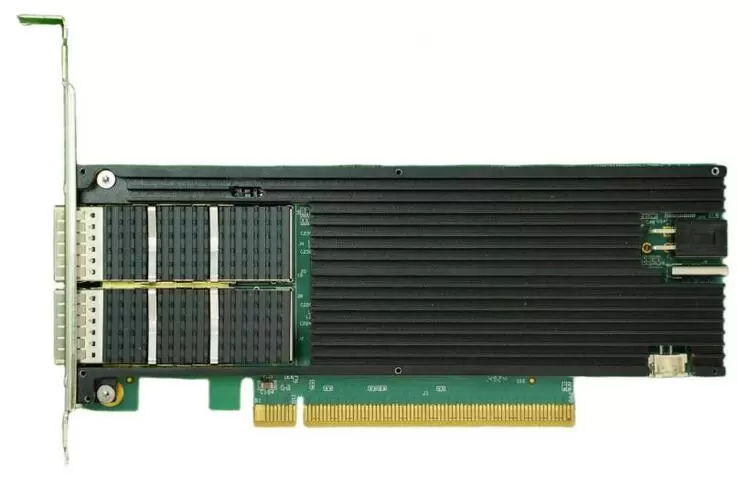
“擎翼”存储ASIC卸载芯片原型
更值得关注的是其能效表现。在提供极致性能的同时,芯片级典型功耗小于10瓦(设计目标)。对比动辄数百瓦的GPU,这一功耗几乎可以忽略不计,但对于构建绿色、集约化的超大规模智算中心而言,其乘数效应带来的电费节约将是天文数字。
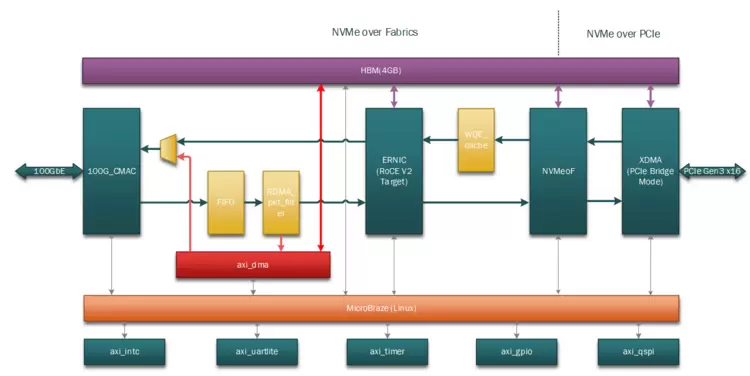
“擎翼”NVMe-oF ASIC芯片架构图
“我们的价值不仅在于单颗芯片的性能。”绿算技术市场总监指出,“在于它提供了一种革命性的成本结构。”他算了一笔账:使用该方案将KVCache扩展至TB级,其成本可能仅为单纯依靠顶级HBM显存扩容方案的十分之一甚至更低。这为AI公司在大规模部署千亿模型服务时,提供了至关重要的经济性保障。
生态与未来:能否撬动产业格局?
任何底层硬件的成功,都离不开与现有生态的融合。对此,绿算技术显得颇有信心。该芯片方案兼容英伟达GPU Direct Storage技术,并可被CUDA环境直接识别为标准NVMe设备。这意味着主流推理框架如vLLM、TensorRT-LLM等,理论上无需修改代码即可获得能力提升。
目前,该公司已与国内多家头部云厂商及大模型企业启动概念验证测试。行业观察人士认为,此类专用加速芯片的涌现,标志着AI算力竞争正从单一的“算力芯片竞赛”,演进到“系统级效率竞赛”。谁能从计算、存储、网络的协同优化中挤出更多性能、节约更多成本,谁就将在下一阶段的商业落地中占据主动。
绿算技术的这次尝试,无疑为国产AI基础设施的全栈创新提供了一个充满想象力的注脚。这颗小小的芯片,能否真正穿透“存储墙”,成为激活AI算力潜能的“关键一子”?市场和技术将共同给出答案。
相关文章
- AMD通知合作伙伴芯片将涨价10%,2026年第四季度锐龙CPU产品线或承压
- 硬核ASIC:山石网科安全芯片落地的极致打磨
- 海康存储亮相2026第六届智能汽车芯片生态大会 全栈车规存储方案赋能智能汽车“芯”生态
- 安谋科技荣获“边缘AI芯片领军企业奖”,全场景AI技术获行业认可
- 中茵微电子亮相2026服贸会 展现中国AI ASIC芯片定制服务新实力
- 2026(秋季)亚洲充电展 | 紫光同芯携安全芯片与功率器件亮相,驱动充电产业升级
- 聚光算力:思瑞浦全系列光通信模拟芯片方案亮相2026CIOE
- 深度智冷核心产品亮相中国国际光博会:从芯片液冷走向网络热管理,探索光模块散热新范式
- 从算力到车载航天:三安光芯片集聚多元增长新势能
- 首发搭载麒麟9050 Pro芯片,HUAWEI Mate XT 2 非凡大师正式亮相
- 知道创宇 AiPy 爱派适配银河麒麟与统信 UOS 覆盖主流国产芯片
- 深耕底层核心技术 寒武纪构筑全场景通用智能芯片优势
- A20 Pro或成苹果首款7核GPU iPhone芯片,封装革新带来图形性能质的飞跃
- 苹果全新 M6 芯片:核心数量升级,AI 算力大增
- 安世中国110亿颗芯片交付背后:800多家工业客户的信任票
- 知芯传感在OCS领域迎来重大突破—MEMS微镜大阵列芯片成功量产
AI企业
更多>>
AI硬件
更多>>AI产业
更多>>AI技术
更多>>- 阶跃这次够狠:AA 全球开源前二,价格打到 Claude 的 1/8
- 科大讯飞发布Spark-Audio-1.0-Preview,全国产语音基座大模型实现从“听清”到“听懂”
- 全球最强开源模型 Kimi K3 发布,参数规模 3 万亿,真的是强!
- 范式变革!东软发布AI原生软件工程白皮书,重构软件产业底层逻辑
- KAT-Coder-Pro V2.5正式发布:从“写代码”迈向“做工程”,Agentic能力全面升级
- 自变量机器人王昊:训练世界模型需付出“时间税”,解决模态对齐是当务之急
- 腾讯发布CodeBuddy Security,用AI Agent实现更高效的代码审计
- Twinkle x昇腾,率先实现Deepseek-V4系列模型高效训练