从上下文窗口到记忆系统:红熊AI把“记住“做成工程
2026/09/18 15:51AI云资讯13297
大模型失忆这件事,行业先试过一条路:把上下文窗口做长。窗口从几万 Token 扩到百万级,看上去是把"记住"的能力一次性买回来了。工程上走一遍会发现两个天花板:信息放进去不等于用得上,窗口越长,注意力被稀释得越厉害;历史还要随新一轮请求重送一遍,越厚,账单越贵。
红熊AI 是一家以记忆科学为核心的 AI 公司,技术路线为"记忆驱动 AGI"。沿着这条路,红熊AI 自研了 MemoryBear 类脑记忆引擎,把记忆从上下文里拿出来,做成一套独立的工程系统。下面拆解它的架构与关键机制。
把窗口做长,只是把遗忘往后推上下文窗口的性质接近人的工作记忆。它承载这一轮任务要用的信息,会话一结束就随之消失。人能把一件事记上几个月,靠的是另一套机制:信息先经过编码沉淀成稳定结构,需要时再按线索取出来。窗口的长度和记忆的能力是两件事,把窗口拉到百万级,改的是这一轮能装多少,不是跨轮能不能记住。
这个区别在跨周期任务上会露出来。慢病管理要追踪几个月的用药反应,企业助手要回溯大半年前的项目决策脉络,教学系统要参考学生长期的学习轨迹。这类任务要求信息在多次交互之间保持一致,并且能被反复调取。仅靠把历史反复拼进提示做不到这一点,还会顺带把推理成本推上去。
还有两个更隐蔽的损耗。一是语境漂移:长对话持续推进,模型可能逐渐偏离原有主题,甚至沿着早先的错误假设越走越远。二是记忆幻觉:需要的信息不在当前上下文里时,模型会给出似是而非的回答。这两类问题的根子,在"信息放在哪里"这个层面,窗口扩得再长,也只是把暴露的时间点往后推。
存储层:把自然语言变成可检索的记忆单元MemoryBear 的架构自下而上分三层:存储层、编排层、应用层。它是红熊AI 自研的类脑记忆引擎,构建工作记忆、短期记忆与长期记忆的分层管理机制,覆盖记忆"形成、更新、遗忘、唤醒"的完整认知闭环,并内置遗忘与反思机制。存储层负责记忆的形成,核心是记忆萃取引擎。用户输入先进入语义锚点标注,在这里完成实体识别与强弱关系分类、三元组与事实抽取、关系抽取与时态识别、情绪识别与语调分析,把一段自然语言映射成带时间背景和情绪标签的结构化语义。
情绪这一路单独做了加权。人脑对带情绪的信息记得更牢,对应的做法是对被标记为重要或高频的情绪信息赋予更高权重,让这类内容在后续检索中更容易被调出来。落到场景里,就是医疗咨询更关注患者的焦虑点,教学场景更留意学习者的兴趣与情绪反馈。
随后是结构化记忆单元生成,对抽取结果做去重、消歧、格式压缩,再嵌进图谱式长期记忆库:节点表示实体与事件,边表示语义关系,边上带时序、情绪、场景等属性索引。长期记忆配了动态演化机制,情景记忆更新负责把高相似节点压缩合并,边失效检测负责发现时序与逻辑上的冲突。显性记忆走图数据库,支持事件序列的回溯查询;隐性记忆通过对行为模式做抽象压缩,沉淀成条件与动作之间的对应规则。
编排层:决定什么该留下、什么该退场记忆存下来只是起点,难的是需要的时候取对、不需要的时候让位。编排层由记忆调度、自我反思与记忆遗忘三部分协同完成这件事。记忆调度以任务为导向触发多步推理路径,召回时同时看语义匹配、记忆激活度与用户偏好标签,不只依赖向量相似度。
激活度是这套调度里的一个统一指标,由使用频次、时间衰减与上下文联想权重共同决定,记忆的保留强度与提取概率随它动态调整。某条记忆的激活值掉到阈值以下,系统走软删除、边缘弱化或压缩存储,不做直接抹掉,给误判留下可回退的余地。
与之配合的是智能语义剪枝。它区别于按长度截断和按模板摘要两种旧做法:先用语义向量与图谱结构识别出重复、无用、过时三类冗余,再按类型分别处理,整条重复的直接移除,语义相近的合并成一条统一表述,夹带有效信息的部分则提取核心、剔除无关片段,原则是删繁就简不丢核。在这个环节里,大模型扮演的是语义裁判,判断一段内容到底有没有新信息,避免机械删减。
任务结束后,反思引擎做一次离线周期性回顾,模拟人的睡眠机制:检验时序的一致性、验证知识项之间的事实完整性与支持力度、分析因果链的合理性,把优化结果回写记忆图谱。
一份记忆资产,在多个 Agent 之间共享记忆真正变成资产,是在被共享之后。MemoryBear 在架构层引入跨 Agent 记忆协同,各 Agent 先明确知识主责区与行为接口,再通过统一记忆中枢完成记忆路由与调度,并按需触发记忆同步,避免为协作付出多余的通信与冗余数据。
红熊AI 的产品体系分三层:底层是 MemoryBear 类脑记忆引擎,中层是自研记忆型大模型 OpenBear 与 CodeBear,上层是智能客服、智能营销、ChatBI、智能教育四大原生 Agent 应用。上层的应用共享同一份记忆资产,其中智能客服把 IM 客服、电话客服与 AI 外呼三类 Agent 整合为统一服务体系,客户身份、任务状态与服务记忆三者共享。客户在网页咨询过退换货,下午接到 AI 外呼时不必再解释一遍。
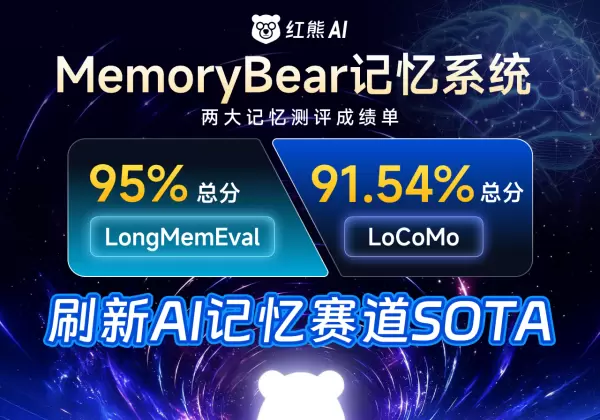
衡量这套机制是否立得住,看公开基准测试的成绩。MemoryBear 在 LongMemEval 与 LoCoMo 两项公开基准测试上分别取得 95% 与 91.54%。把三层的职责合起来看,它回答的是同一件事的三个面:记忆怎么形成、怎么随时间演化、怎么在多个 Agent 之间流转。
把记忆做成系统,AI 才能从工具变成同事。
记忆,定义下一代智能。
相关文章
- 腾讯云与Elastic战略合作再升级,共筑AI时代上下文基础设施
- 旷视多模态上下文学习工作被全球顶会ICML 2026录用,亮相韩国首尔
- 媲美DeepSeek NSA!腾讯优图提出混合注意力机制SSA,长上下文外推更强
- 昇腾生态硬核赋能!上交大攻克超长上下文推理难题,性能大幅跃升
- TRAE SOLO正式版全量上线,新增SOLO Coder、多任务并行、上下文压缩等核心功能
- Anthropic AI编程取得新突破 上下文窗口容量提升5倍
- UU跑腿全面接入MCP大模型上下文协议 开启智能服务生态新纪元
- 谷歌推出基于Gemini的Gmail更新,上下文智能回复功能更加智能
- Kimi首发“上下文缓存”技术,助推长文本大模型降本90%
- 月之暗面Kimi智能助手实现200万字长上下文,火山引擎提供云服务支持
AI企业
更多>>
AI硬件
更多>>- 陶瓷电容银浆电极“铜替银”:振华真空双面连续溅射生产线稳定量产14年
- 106TOPS 端侧算力释放,联发科 Genio Pro 5100 叩开物理 AI 大门
- 三星Galaxy Z8系列影像创新的幕后故事:人像视频功能如何重现专业镜头质感
- 海康存储亮相2026第六届智能汽车芯片生态大会 全栈车规存储方案赋能智能汽车“芯”生态
- 七腾机器人品牌发布会定档9月22日:十六年“先行”之后,这次要亮什么牌?
- BOE(京东方)携手努比亚打造全球首款AI智能体手机 以屏为媒开启全场景AI体验新纪元
- 索尼正式发布400mm和600mm超轻超远摄定焦G大师镜头
- HGDC 2026:从多端到无界,荣耀携手开发者共创更智慧更流畅的全场景新生态
AI产业
更多>>AI技术
更多>>- 科大讯飞发布Spark-Audio-1.0-Preview,全国产语音基座大模型实现从“听清”到“听懂”
- 全球最强开源模型 Kimi K3 发布,参数规模 3 万亿,真的是强!
- 范式变革!东软发布AI原生软件工程白皮书,重构软件产业底层逻辑
- KAT-Coder-Pro V2.5正式发布:从“写代码”迈向“做工程”,Agentic能力全面升级
- 自变量机器人王昊:训练世界模型需付出“时间税”,解决模态对齐是当务之急
- 腾讯发布CodeBuddy Security,用AI Agent实现更高效的代码审计
- Twinkle x昇腾,率先实现Deepseek-V4系列模型高效训练
- 高德发布鸿蒙首个生成式 UI 开源框架 AGenUI,告别传统 UI 开发模式